


NutanixのアーキテクトがNutanixの未来を語る
ハイパーコンバージドのNutanixのアーキテクトにコンテナーやGPU対応などについて訊いた。
2018年10月24日 6:00
コンピュートノードとストレージノードを統合してスケーラブルなクラスターを構成するハイパーコンバージドインフラストラクチャーは、運用の容易さと拡張のしやすさからクラウドネイティブなシステムをオンプレミスで構築する場合の選択肢のひとつになっている。そのハイパーコンバージドインフラストラクチャーというジャンルを産み出し、多くのフォロワーを作ったのがNutanixだ。今やNutanix自身は、インフラストラクチャーだけではなく、アプリケーションレイヤーにも拡張を行いながら自社のソリューションの領域を拡大している。
そのNutanixのプライベートカンファレンスである「Nutanix .NEXT on Tour」が2018年9月に都内で開催された。1日だけのカンファレンスだったが、申し込みが2500名を超えるという盛況となった。
イベントに合わせて来日したNutanixのプリンシパル・ソリューション・アーキテクトであるスティーブン・ポイトラス(Steven Poitoras)氏にインタビューを行った。ポイトラス氏はアーキテクトとして製品開発に携わると同時に、Nutanix BibleというNutanixのアーキテクチャーを解説する詳細な技術情報の著者でもある。ポイトラス氏に、Nutanixの今後の方向性などについて話を聞いた。
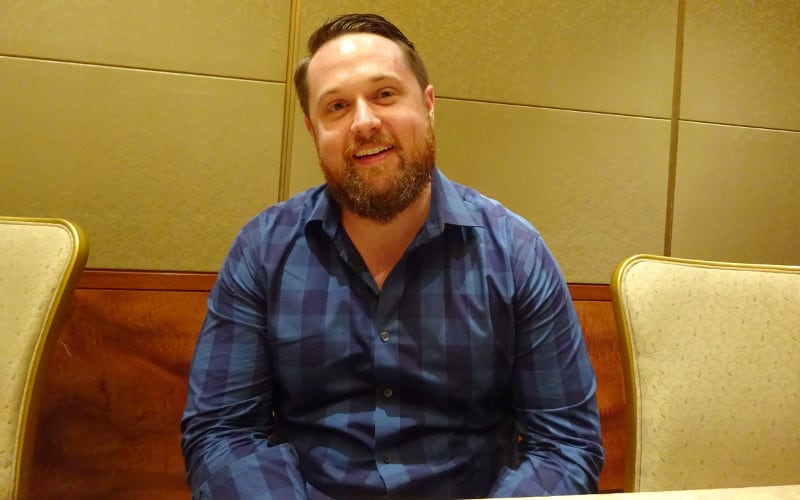
インタビューに答えるポイトラス氏
まず自己紹介をお願いします。
私は、Nutanixのアーキテクトとして仕事をしていますが、以前はアクセンチュアのテクノロジーラボで次世代データセンターの研究開発を行っていました。そのため、Ciscoのサーバーや各社のストレージについては詳しかったのです。そのうち、私の友人がNutanixに移ったということで、サンノゼでその友人に会ってコーヒーでも飲もうと訪れたところ、結果的にはNutanixのCEOなど4人と面接を行うことになってしまって、それがきっかけでNutanixに入社することになりました。
友人とお茶をするつもりだったのが、ジョブインタビューになったということですね(笑)
そうです(笑)。最初にハイパーコンバージドインフラストラクチャーのことを聞いた時は、正直なところ少し懐疑的でした。ですが、話を聞いているうちにこれは凄いコンセプトだと気付いたのです。まず何よりも会った人たちがとても知識と経験が豊富で、しかも情熱的だったことに感動しました。CEOのディラージ・パンディとは2時間も話をしたのですが、そこでこのアイデアが素晴らしいものであるということに気付いたのです。
またたとえNutanixのチャレンジが結果的に失敗に終わったとしても、この経験は自分自身のためになるということがわかりました。当時、VMwareなどが考えていたコンバージドインフラストラクチャーは、期待されていたほど結果を残せていなかったと思います。しかしNutanixの考えるインフラストラクチャーであれば、モジュラーで運用が容易なインフラストラクチャーを実現できると思ったわけです。
現在、多くのクラウドネイティブなアプリケーションはコンテナをベースにする方向にシフトしています。NutanixもACS(Acropolis Container Services)を発表しましたが、ベータを取りやめ、リエンジニアリングを行っていると聞いています。コンテナベースのワークロード、特にKubernetesで構成されたアプリケーションを運用するためのNutanixとしての回答は?
その通りです。ACSを発表した当初は、まだコンテナオーケストレーションには多くのプレイヤーがいました。Docker SwarmもMESOSも有力なコンテンダーだったのです。ですが、今となってはKubernetesがコンテナオーケストレーションの役割を担っていると言っていいと思います。我々の当初の目的は、様々なコンテナオーケストレーションソフトウェアをサポートすることでしたが、それをKubernetesに絞って実現しようとしています。
基本的にはKubernetesの運用ツールをそのまま使えるようにすることが最初のゴールになりますが、Nutanixの既存顧客のことを考えると、NutanixのダッシュボードであるPrismを使って、仮想マシンでもコンテナでも同じようにコントロールできるようにするのが最終的なゴールです。例えば、WebサーバーやHA Proxyなどはコンテナベースで運用するべきだと言うのは自明だと思いますが、まだデータベースなどについては仮想マシンベースで残るだろうと思います。その時にPrismからどちらも運用できる、というのがあるべき姿だと思います。
例えば、LAMPスタック(Linux、Apache、MySQL、PHPで構成されるWebアプリケーションのためのソフトウェアスタック)の運用を考えてみましょう。Apacheはコンテナで運用したとしても、MySQLを仮想マシンベースで使いたいというユーザーは存在します。これからのユーザーにとって重要なのは、具体的に何をどう構成して運用するのか? ではありません。もっと抽象化されていくべきだと思います。アプリケーションデベロッパーにとっては、下のレイヤーがどのように構成されているのかは問題ではないようになるのではないでしょうか。Nutanixにおいては、Calm(注1)のブループリントを使ってそれを実装できれば良いと考えています。
注1:Calmは2017年にNutanixが発表したアプリケーションのライフサイクルマネージメントソリューション。ダッシュボードであるPrismから、事前に用意されたブループリントを使ってアプリケーションを実装できる。
これはNutanixのOpenStackに対する方法と同じです。Nutanixで稼働するOpenStackは、それぞれのサービスからのリクエストをNutanixのインフラストラクチャーにマッピングして実行されます。コンテナについてもKubernetesクラスターからのリクエストは、Nutanixのリソースにマッピングされて実行されることになります。そのため、Kubernetesのコマンドラインを使って操作することもできますし、Prismを使って操作することもできるようになります。これはOpenStackやKubernetesに詳しいエンジニアに無理矢理Prismを使わせるということではなく、使い慣れたツールを使って運用を行えるように、選択肢を用意するということです。
究極的にはPrismをユーザーが利用する単一の窓口にしたいというのはわかります。実際にハイパーコンバージドインフラストラクチャーとして統合されている意味はそこにもあると思いますから
そうです。なにか問題があったとしても、ハードウェアとソフトウェアをNutanixがサポートすれば、ユーザーにとってはハードウェアもソフトウェアも全てNutanixに問い合わせれば完了しますよね。
Nutanixは、Nutanix Flowというネットワークサービスも提供するようになりました。これはパンフレットだけ見れば、マイクロセグメンテーションを実現しているということで、VMwareのNSXと良く似ているように思えます。VMwareから苦情は来ませんでしたか?(笑)
我々とVMwareは、Co-opetition(競合しながら協力するという造語。cooperation+competition)の状態にあると思います。私自身もかつては週に何度もVMwareのオフィスに打ち合わせなどに行っていましたが、お互いが競争しながらもある部分では協力するということは続いていると思います。
次の質問です。人工知能がGPUの応用によって注目されています。機械学習のためのGPUを搭載したNVIDIAのサーバーなどをNutanixから利用することは可能なのでしょうか?
GPUやvGPUは、すでにNutanixのアプライアンスやNutanixが提供するハイパーバイザーであるAHVだけではなく、ESXiでもサポートされています。またNutanix自身も機械学習を使って異常検知のために利用しています。これはコンピュートノードやストレージのタイムシリーズデータを使って、機械学習することで異常を予測するというものです。しかしNVIDIAが開発するGPUを大量に積んだサーバーにGPUをフルに使うようなワークロードを投入するといった使われ方に関しては、今のところ想定していません。
もうひとつの流れとしてサービスメッシュが注目されています。アプリケーションを細かく分割して連携させることでクラウドネイティブなシステムを作ろうとする流れですが、その際の問題点として可視化やトレーシングをちゃんとやらないといけないということがありますが、Nutanixとしての答は?
そのためにNutanixはNetsilという会社を買収しました。これはマイクロサービスの可視化と、大量に発生するログのリアルタイム処理を実行します。これによってマイクロサービスやサービスメッシュのようなワークロードの運用管理も可能になると思います。
最後にNutanixにとってのテクノロジー面でのチャレンジは?
「正しいことを正しく実行する」ということですね。Nutanixのソフトウェアは目的に向かって正しく開発され、実装されていると思いますが、多くのIT企業では買収したソフトウェアを後付けするようなやり方でリリースすることがあります。単に複数のソフトウェアをダクトテープで繋げるようなやり方ですね。これは正しくありません。NutanixはCalmを買収した後、すぐにリリースするのではなく、十分に時間を使って統合を行っています。こういう方法論を取ることが必要だと考えています。またNutanixのソフトウェアは多くのオープンソースソフトウェアをベースにしていますが、バグの修正などについてコミュニティへの還元を行っています。これについては、まだそれほど周知されていないように感じています。これに関しても、もっと積極的に情報を公開していく必要があると思っています。
Nutanixはオンプレミスのクラウドインフラストラクチャーからアプリケーションライフサイクル、ネットワークサービス、さらにマイクロサービスのモニタリングと、時代の流れに従って先手を打っているということが分かるインタビューだった。GPUクラスターのサポートについては少々残念な回答となったが、これも優先順位の問題で市場ニーズに合わせて対応していくことになるだろう。コンテナに最適化され、ネイティブなKubernetesに対応したマイクロサービスへの対応を今後も注目していきたい。
- この記事のキーワード
この記事をシェアしてください
バックナンバー


この記事の筆者

筆者の人気記事

マニュライフ生命のAIの責任者にインタビュー。全社員がAIを使いこなすAI for Allとは?
10月2日 6:00

【OSS Summit North America 2026】Netflixのエンジニアが開発したコンテキストを圧縮するオープンソース、Headroomを紹介
10月9日 6:00

【KubeCon Japan】KubeCon Japan 2026開催。オープンなAIを推奨する初日のキーノートを紹介
10月23日 5:59

LF Energyがミートアップを実施。ヨーロッパとの違いが際立ったプレゼンテーションを紹介
10月6日 6:00

【OSS Summit North America 2026】ドローンのグラウンドコントロールシステムであるQGC(QGroundControl)に関するセッションを紹介
11月4日 6:00

【KubeCon Japan】CNCFのリサーチ「クラウドネイティブ開発の現状」から見える日本のITが抱える問題点を考察する
10月7日 6:00
Think ITでは、技術情報が詰まったメールマガジン「Think IT Weekly」の配信サービスを提供しています。メルマガ会員登録を済ませれば、メルマガだけでなく、さまざまな限定特典を入手できるようになります。

