


負荷分散の設定
負荷分散の設定
pgpoolAdminの「pgpool.conf設定」画面から「Others」セクションの「load_balance_mode」にチェックして、pgpool-IIを再起動すると負荷分散が行われます。
「pgpoolステータス」画面の「サマリー」ボタンを押して、ロードバランスモードがオンになっているかを確認しましょう。
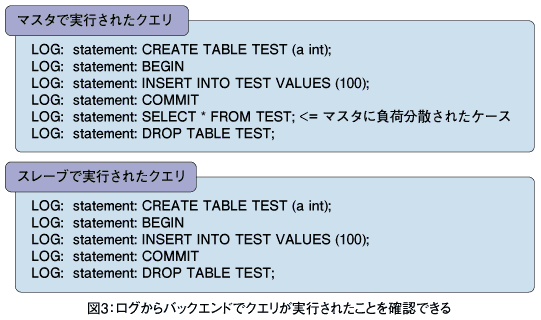
なお、postgresql.confの「log_statement」を「'all'」と設定しPostgreSQLを再起動することで、実際にバックエンドで実行されたクエリをログに出力することができます。
psqlからpgpool-IIへの接続、切断とSELECT文の実行を繰り返すことで、負荷分散が行われていることが確認できたでしょうか。
そのほかの設定と注意事項
ここでそのほかの設定項目と注意事項についてまとめておきます。
1つ目が「フェイルオーバー」に関する設定です。もしバックエンドのうちの1つが故障してしまった場合、pgpool-IIは自動的に障害が発生したノードを切り離して、サービスを継続することができます。また、「failover_command」に任意のコマンドを設定することで、バックエンドが切り離された時に任意のコマンド(例えば障害通知メールを送信するなど)を実行させることができます。
なお、バックエンドに障害が発生したかどうかは通常はクエリを実行した時にチェックされますが、ヘルスチェックを利用することにより、クエリを実行していない時でも定期的にバックエンドの状態をチェックすることができます。
具体的には「health_check_period」にヘルスチェックを行う間隔を、「health_check_timeout」にはバックエンドが無応答の場合のタイムアウトの時間を秒間隔で指定します。
2つ目が「不整合の検出」です。更新系のクエリを実行した時に、すべてのバックエンドが同じ更新件数とならなかった場合は、データの整合性を保つためにエラーとなります。
参照系のクエリでも「replicate_select」をonにすることで、SELECT文の件数の不一致などを検出することができます。これはSELECT文をすべてのバックエンド上で実行するかどうかの設定で、offの場合はSELECT文を最も番号の若いバックエンドでのみ実行します。ただし、load_balance_modeがonの場合はSELECT文は負荷分散されるため、SELECTの結果の不一致を検出することはできません。
また「replication_stop_on_mismatch」をonにすると、データの不一致を検出した時に単にエラーを返すだけでなく、自動的にバックエンドを切り離します。
このように、pgpool-IIはさまざまなタイミングで、各バックエンドからの応答の整合性をチェックしています。このため、レプリケーションを構成する場合は各ノードのデータベースインスタンスが完全に同じ構成の状態で開始する必要があります。
3つ目が「SERIAL型の使用」です。SERIAL型の列をもつテーブルに対して複数のクライアントからINSERTを行うと、各バックエンド間でSERIAL型の列の値が不一致になってしまうことがあります。この問題は、該当テーブルを明示的にロックすることで回避できます。これを自動的に行う設定が「insert_lock」です。
また、INSERT文の前にコメントを挿入することで、この明示的なロックを行うかどうかをクエリごとに指定することもできます。
insert_lockがOnの場合、「/*NOINSERT LOCK*/INSERT INTO...」とすると明示的なロックは行われません。また、insert_lockがOffの場合、「/*INSERT LOCK*/INSERT INTO...」とすると明示的なロックが行われます。
4つ目が「レプリケーションのオーバーヘッド」です。pgpool-IIはまずマスタにクエリを送信し、その後すべてのスレーブに一斉にクエリを送信します。このため、レプリケーション時の応答時間は、バックエンドの数が3台以上の場合でも通常時のおよそ2倍となります。
ただし、1台だけ遅いバックエンドが存在する場合は、全体の性能が低下してしまうので、注意が必要です。ベンチマークでは、システム全体の約6~7割が参照系であれば、負荷分散を有効にして高速化をはかることで、レプリケーションの性能低下はカバーされ、結果としてPostgreSQL単体よりも性能が出ました。レプリケーションを導入する際にはあらかじめベンチマークを実行し、期待した性能が出るかご確認ください。
5つ目が「レプリケーションの制限」です。pgpool-IIのレプリケーション機能は、各バックエンドで同じSQLを実行することで実現しています。このため、同じSQLを実行しても同じ結果にならない関数に注意が必要です。例えばrandom()関数や、現在の日時を取得するnow()やcurrent_timestampなどの関数を使った場合、各バックエンドで異なる結果となります。
今回は、pgpool-IIのレプリケーションと負荷分散の機能について紹介しました。次回は、pgpool-IIをほかの非同期レプリケーションと組み合わせて使う方法を紹介します。
- この記事のキーワード
この記事をシェアしてください
バックナンバー
この記事の筆者

Think ITでは、技術情報が詰まったメールマガジン「Think IT Weekly」の配信サービスを提供しています。メルマガ会員登録を済ませれば、メルマガだけでなく、さまざまな限定特典を入手できるようになります。

