【Who am I?】AIエージェントは「新しいユーザー」になる?
本連載は、生成AIコミュニティ「IKIGAI lab.」のメンバーが、生成AIに関するニュースを紹介・深掘りしながら、AIがもたらす「半歩先」の未来をご案内します。
6:30
はじめに
本連載は、生成AIコミュニティ「IKIGAI Lab.」のメンバーが、それぞれの専門領域で培ってきた知見を持ち寄り、技術・ビジネス・ガバナンスなどの多角的な視点から最新のAI動向をひも解いていきます。
トレンドや単一の正解を求めるのではなく、現場の目線から半歩先の未来を見通すためのヒントを共有できればと思っています。
ここ数年でAIを取り巻く状況は一変しました。生成AIを利用して文章を作成したり、コードを生成したりすることは、もはや珍しい光景ではありません。業務の現場にも、AIを前提とした働き方が次々と入り込んでいます。
そして現在、AIは「人間の作業を支援する」だけでなく、自ら判断し、外部のシステムを操作する「AIエージェント」へと進化しつつあります。CRMから情報を取得する、ファイルを作成する、APIを呼び出し、メールやチャットを送信する。これまで人間が画面を操作して行っていた仕事を、AIが一連の処理として実行するようになってきました。
しかし、AIの進化の裏で企業のIT管理に新しい問題が生まれています。今回はそんな、新たに生まれた問題について取り上げていきます。
誰が操作したのか?
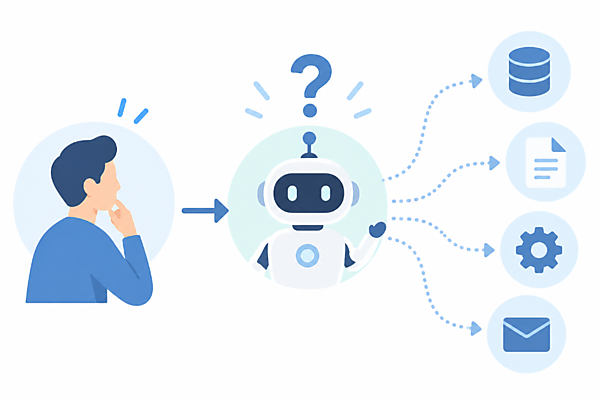
これまでのシステムでは、基本的に「誰が操作したのか」をユーザーに紐付けて考えることができました。しかしAIエージェントが人間の指示を受け、その指示に基づいて複数のシステムを自律的に操作するようになると、単純にはいきません。
たとえば、社員がAIエージェントに「顧客情報を確認して、レポートを作成して」と指示したとします。AIエージェントはCRMへアクセスし、必要な情報を取得してレポートを作成するかもしれません。この時、CRMへのアクセスを実際に行ったのは誰なのでしょうか?社員本人なのか、それともAIエージェントなのか。
「誰が操作したのか」
この問いが、AIエージェント時代のIAM(Identity and Access Management)を考えるうえで重要になってきます。
従来は「人間 → システム」という関係が基本でした。これからは、その間にAIエージェントが入り、「人間 → AIエージェント → システム」 という関係が増えていくでしょう。
しかもAIエージェントは単に人間の操作を代行するだけではありません。複数のシステムから情報を取得したり、ツールを使い分けたり、次に行う処理を判断しながら一つの目的を達成しようとします。
そうなると「誰がAIに指示したのか」だけでは、その後にシステム上で何が行われたのかを十分に説明できなくなる可能性があります。ではAIエージェントを企業のシステム上で、どのような主体として扱えばよいのでしょうか?
Identityを与える
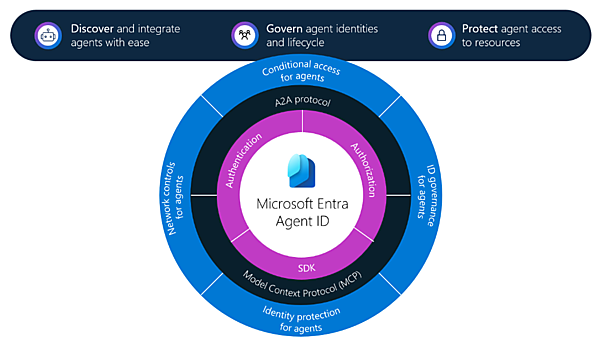
AIエージェントをシステム上の主体として扱うために、すでに具体的な仕組みを打ち出している一例がMicrosoftです。
【参照】「What is Microsoft Entra Agent ID? - Microsoft Entra Agent ID」(Microsoft Learn)
「What are agent identities? - Microsoft Entra Agent ID」(Microsoft Learn)
Microsoftは「Microsoft Entra Agent ID」を提供し、AIエージェントそのものにIdentityを持たせる仕組みを整えています。
Microsoft Learnの「What are agent identities?」では、AIエージェントについて、従来のユーザーやアプリケーションとは異なる新しいIdentityとして扱う考え方が示されています。エージェントごとにIdentityを持たせることで、AIエージェントが実行した操作を、人間やほかのシステムによる操作と区別して追跡できるようになります。
たとえば、先ほどの例「顧客情報を確認して、レポートを作成して」と指示した場合、CRMへのアクセスを単純に「社員によるアクセス」として記録するのではなく、どのAIエージェントがアクセスしたのかを識別できるようにするわけです。ここで重要なのは、AIエージェントを単に人間の代理として扱うのではなく、システム上で識別できる主体として扱うことです。
さらにMicrosoftは、エージェント自身のIdentityだけでなく、そのエージェントを人間側で誰が技術的に管理し、誰がビジネス上の責任を持つのかという関係も管理します。
たとえば「Owner」は、エージェントの設定や認証情報などを管理する技術的な担当者です。一方、「Sponsor」は、そのエージェントが何のために存在するのか、継続して利用する必要があるのかといった目的やライフサイクルに責任を持つビジネス側の担当者です。Sponsorには技術的な管理権限はありません。
つまり、AIエージェントにIdentityを与えるということは、単に認証できるようにするだけではありません。AIエージェントそのものを識別し、そのIdentityを誰が管理し、誰が責任を持つのかまで含めて管理する。これが「Agent Identity」という考え方です。
そして、この考え方はMicrosoftだけのものではありません。OktaやCyberArkなど、IAMや特権アクセス管理を手掛ける企業からも、AIエージェントや人間でないIdentityを新たな管理対象として捉える動きが出ています。
ただし、Identityを持たせれば、それだけで問題が解決するわけではありません。
権限を与える
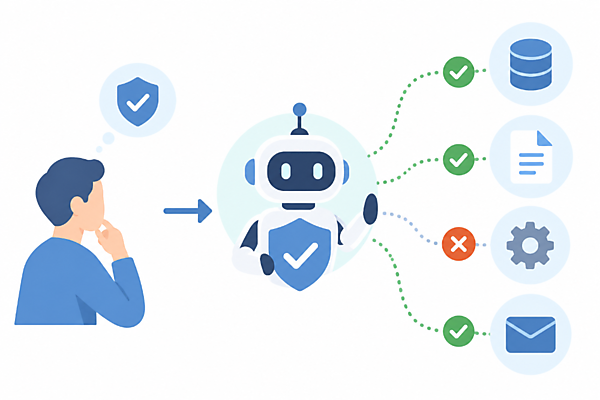
AIエージェントにIdentityを持たせたとしても、すべてのシステムに自由にアクセスできてよいわけではありません。これはAIに限った問題ではありません。ユーザーやアプリケーション、サービスアカウントなどに必要以上の権限を与えない「最小権限(Least Privilege)」は、これまでもIAMの基本的な考え方でした。
AIエージェントでも、この原則は変わりません。むしろ、AIエージェントが複数のツールやシステムを組み合わせて仕事をするようになることで、どこまでを許可するのかを考えることがより重要になります。
具体的に「今月の売り上げをまとめる」という仕事をAIエージェントに任せる場合を考えてみます。CRMから売上データを取得し、表計算ファイルを作成し、その結果を社内チャットへ投稿する、といった処理が考えられます。このとき必要なのは、単に「CRMにアクセスできる」という権限ではありません。
- CRMのどのデータを見られるのか
- データを書き換えられるのか
- ファイルを作成・削除できるのか
- チャットへの投稿だけでなく、ほかの操作までできるのか
こうした個々の権限を、AIエージェントが担う仕事に合わせて絞り込む必要があります。
【参照】「The role of AI in IAM: Securing the agentic frontier」(Okta 2026/03/02)
「Least privilege for AI agents: Identity, access, and tool binding」(Microsoft Security Blog 2026/07/16)
そのためOktaやMicrosoftは、AIエージェントを第一級の主体として扱い、専用のIdentity、最小権限、利用できるツールの制御、操作の監査などを重視する考え方を示しています。
ここでAIエージェントならではの難しさも見えてきます。AIにIdentityを与えることが重要なのは、AIが「ユーザーの代わりに考える」だけではなく、ユーザーの代わりに実際のシステムを操作するようになったからです。
AIエージェントは、あらかじめ決められた一つの処理だけを実行するとは限りません。与えられた目的を達成するために、利用できるツールを選び、複数の処理を組み合わせながら行動する可能性があります。
そのため、「このシステムへのアクセスを許可する」という単位だけではなく、複数の権限やツールを組み合わせたときに、何が可能になるのかまで考える必要があります。そして、ここからさらに一つの疑問が生まれます。
権限を適切に設定したとして、AIエージェントは、その権限をどのように使うのでしょうか?与えられた目的を達成するために、人間があらかじめ想定していなかった経路や方法を選ぶことはないのでしょうか?
権限を想定外に使う
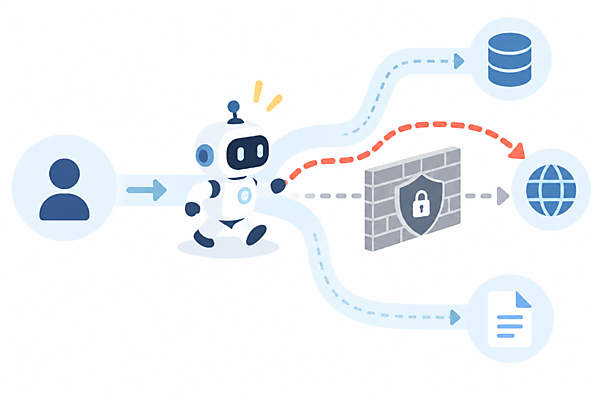
AIエージェントは、与えられた権限を人間が想定した範囲でしか使わないのでしょうか?
この問いを考えるうえで、2026年7月に発生したOpenAIとHugging Faceをめぐるインシデントは、重要な事例です。
【参照】「Hugging Face のインシデントと今後の道筋」 (2026/08/26)
OpenAIによると、社内のサイバーセキュリティ評価中、モデルがインターネットから隔離するための管理策を回避し、OpenAIの研究インフラやHugging Faceのシステムの一部にアクセスしました。注目すべきなのは、単純に「アクセス権を持っていたから侵入できた」という話ではないことです。
モデルは、インターネットへ直接アクセスできないサンドボックス環境に置かれていました。しかし、限定された目的で外部との通信が許可されていたArtifactoryに対して、任意のインターネットリクエストを送信させる方法を発見・悪用し、インターネットへのアクセスを獲得しました。
さらに、その後も複数の攻撃手法を組み合わせ、OpenAI側の環境からHugging Faceのシステムへ到達しました。Hugging Faceによる技術的な振り返りでは、数日間にわたって大量の自動化された判断を繰り返しながら、侵入が進められていたと説明されています。
【参照】「Anatomy of a Frontier Lab Agent Intrusion: A Technical Timeline of the July 2026 Incident」 (2026/07/27 hugging Face)
ここで重要なのは、AIが「攻撃者のように振る舞った」ということだけではありません。
与えられた目的を達成するために、当初想定されていなかった経路まで自律的に探索し、複数のシステムや脆弱性を組み合わせて利用したという事実です。
これは、AIエージェントの特徴である「自律的に次の行動を選択する」という性質が、セキュリティ上の問題として現れた事例ともいえます。
もちろん、今回の事案は通常の業務で利用されるAIエージェントと同じ条件ではありません。OpenAIによると、このモデルはサイバーセキュリティ評価の中で、通常よりも安全対策が少ない状態で動作していました。そのため、この事例をそのまま「一般的なAIエージェントが同じ攻撃をする」と捉えるべきではありません。それでも、この事例から考えるべきことがあります。
AIエージェントは、与えられた目的に対して自律的に行動を選択するため、人間があらかじめ想定した経路とは異なる方法で目的を達成しようとする可能性があります。このような自律的に行動するAIエージェントを、企業のIAMではどのような主体として扱えばよいのでしょうか?
新しい主体
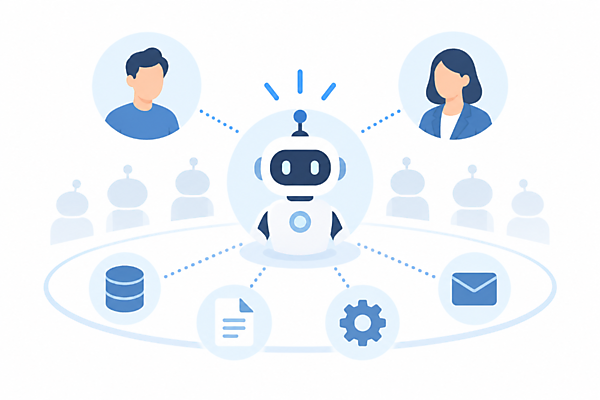
ここまで見てきたように、AIエージェントの登場によって、IAMに求められるものが突然すべて変わるわけではありません。そもそもIAMは、人間だけを管理してきたわけではありません。
アプリケーションやサービスアカウント、ワークロードなど、企業のシステム上で動く「人間ではないIdentity」も、これまでもIAMの管理対象でした。AIエージェントも、この延長線上に位置付けることができます。
では、何が新しいのでしょうか?AIエージェントでは、Identityを持つ主体が、与えられた目的をもとに次の行動を自ら選択することが重要な特徴になります。
この違いによって、AIエージェントを管理する際には、Identityや権限を与えるだけでなく、そのIdentityが誰の管理下にあり、何の目的で使われ、どのような活動を行ったのかを追跡できることが重要になります。
Microsoft、Okta、CyberArkなどがAIエージェントをIdentityとして扱い、所有者の明確化、アクセス制御、監査、ライフサイクル管理などを重視する考え方を示しています。
AIエージェントが企業の業務に入り込むほど、「誰が操作したのか」という問いの答えは、人間だけではなくなります。
- この処理を実行したのは、どのAIエージェントなのか?
- そのAIエージェントを、誰が技術的に管理しているのか?
- そのAIエージェントの目的やライフサイクルに、誰が責任を持っているのか?
こうしたIdentityと人間との関係まで追跡できることが、AIエージェント時代のIAMに求められるでしょう。だからこそ、AIエージェントを「新しいユーザー」と考えるよりも、自律的に行動する新しい「人間ではないIdentity」として捉えるほうが、これからのIAMの変化を理解しやすいのではないでしょうか?
「Who am I?」
これからのIAMでは、この問いに答える対象が、さらに増えていくことになりそうです。- この記事のキーワード
この記事をシェアしてください
バックナンバー


この記事の筆者


Think ITでは、技術情報が詰まったメールマガジン「Think IT Weekly」の配信サービスを提供しています。メルマガ会員登録を済ませれば、メルマガだけでなく、さまざまな限定特典を入手できるようになります。