


インデクシング速度の比較実験
インデクシング速度の比較実験 「第2回:検索エンジンの選定と評価項目」では、全文検索システムを比較するにあたってはさまざまな評価項目があることを解説しました。
2008年12月17日 20:00
インデクシング速度の比較実験
「第2回:検索エンジンの選定と評価項目」では、全文検索システムを比較するにあたってはさまざまな評価項目があることを解説しました。
今回はインデクシングの速度やインデックスのサイズを実際に測定/比較していきます。比較対象とするのは、Namazu、Lucene、Estraier、Hyper Estraier、Sennaの5つの全文検索システムです。
この実験では、日本語で書かれた文書を実際にインデックスに登録して、その速度を測定しました。登録する文書には、電気通信大学 尾内・林研究室(http://www.seman.cs.uec.ac.jp/)で開発し、公開実験を行っていた画像付きblog検索システム「もぶろげっと」の収集したブログのページを使用しました。
文書はブログの1エントリを1つのファイルとして、ファイルシステムに保存してあります。インデクシング時の文字コード判別/変換処理を省くため、あらかじめすべての文書をEUC-JPに変換しました。また、今回の実験ではHTMLの解析をせず、すべてプレーンテキストとして扱いました。
インデクシングは、文書数を1万から100万まで徐々に増やしながら行いました。最初はインデックスを作成し、1万ファイルの文書を登録、かかった時間を測定しました。その後は2万、3万と1万ずつ追加していき、文書数10万になるまで所要時間の測定を繰り返しました。10万以降は20万、30万と10万ずつ追加していき、文書数が100万になったところで実験を終了しました。
文書はすべて1つのディレクトリ内に置き、その中から未登録の文書のみをインデックスに登録しました。つまり、2万ファイルのインデックスを登録する際は、2万ファイルを読み、登録済みの1万ファイルをスキップして未登録の1万ファイルをインデックスに追加登録する、という処理になります。
これは、実際に運用する際には毎回同じディレクトリを指定するのが一般的であると考えられ、登録済みで更新のない文書や以前の登録の後に更新のあった文書、未登録の文書を判別する処理能力についても測定の必要があると判断したためです。
今回の実験では、各全文検索システムでメモリ使用量を設定できる場合、なるべく多く使うように設定しました。数値を入れる場合には、それぞれの公式サイトの記述を参考に値を決めています。
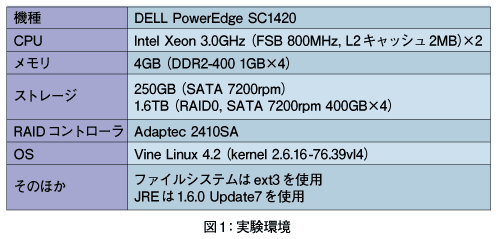
実験は図1に示した構成の計算機で行いました。OSやソフトウエアは250GBのハードディスクにインストールし、文書とインデックスはRAIDのストレージに配置しています。
比較対象の全文検索システム
実験で比較対象とする全文検索システムと形態素解析器は以下のようになります。
・Namazu 2.0.18+MeCab 0.97
・Lucene 2.4.0+Sen 1.2.2.1
・Estraier 1.2.29+MeCab 0.97
・Hyper Estraier 1.4.13
・Senna 1.1.3+MeCab 0.97
Namazuのインデクシングでは、形態素解析器にMeCabを使用しました。このとき、MeCabはPerlモジュールとして使用しています。Perlモジュールを使用しない場合、10倍以上の時間がかかってしまうこともあります。
設定ファイルmknmzrcでは、使用メモリ量を指定する$ON_MEMORY_MAXを500,000,000に設定しました。また、実行時には全文書をプレーンテキストとして扱うように"--media-type=text/plain"というオプションを指定しました。
Luceneは形態素解析の場合とN-gramの場合の2パターンでインデクシングを行いました。単語分割を形態素解析で行う場合、形態素解析器にはSenを使用しました。実験ではディレクトリ内を再帰的にたどり、ファイルをインデクシングするテストコードを作成し、使用しました。実行時には、javaコマンドの引数として-Xmx1024Mを指定し、最大ヒープサイズを1GBに設定しました。
Estraierのインデクシングでは、形態素解析器にMeCabを使用しました。実行時には、全文書をプレーンテキストとして扱う「-tsuf」オプション、文字コードを指定する「-enc」オプション、50万文書以上を想定してRAMやディスクを使う「-plute」オプションを指定しました。
Hyper Estraierのインデクシングでは、初回と2回目以降で実行時オプションを変えています。初回では「-tr -ft -sd -ic EUC-JP -cs 1600」と指定しています。2回目以降は「-cm -cl -ft -sd -ic EUC-JP -cs 1600」です。性能比較時に重要になるのはキャッシュメモリのサイズを指定する「-cs」オプションです。今回の実験では1600MBを指定しています。
また、対象文書の文字コードを指定する「-ic」オプションや対象の全文書をプレーンテキストとして扱う「-ft」オプションを指定しています。初回のみ指定している「-tr」オプションはインデックスを必ず新規作成するよう指定するオプションです。
2回目以降で指定している「-cm」や「-cl」はインデックスの更新に関するオプションです。両方で指定している「-sd」オプションではファイルの更新日時を文書の属性として追加します。
Sennaのインデクシングでは、形態素解析器にMeCabを使用しました。実験ではディレクトリ内を再帰で読み込み。インデクシングするテストコードをJavaで作成し、使用しました。テストコードには、SennaのJavaバインディングを使用しました。ただし、登録済み文書かどうかを調べるのに必要なAPIが使えなかったので、そのAPIを追加した改変版を使用しています。インデクシング以外の処理はLuceneのテストコードと共通のコードを使用し、なるべく条件を同じにしています。
- この記事のキーワード
この記事をシェアしてください
バックナンバー
この記事の筆者

Think ITでは、技術情報が詰まったメールマガジン「Think IT Weekly」の配信サービスを提供しています。メルマガ会員登録を済ませれば、メルマガだけでなく、さまざまな限定特典を入手できるようになります。

