【クラウドネイティブ会議】クラウドネイティブDBが乗り越えてきた3つの壁から学ぶ分散システム設計の指針
スケーラブルなクラウドネイティブDB実現のために必要な壁(制限)の克服の指針を、DBの進化をたどることで導出したセッションを紹介する。
6:01
株式会社hacomonoのプリンシパルエンジニア(分散システム)の上田義明氏が「クラウドネイティブ会議 2026」に登壇し、「クラウドネイティブDBはいかにして制約を克服したか? ~進化の歴史から紐解く、スケーラブルアーキテクチャの設計指針~」と題したセッションを実施した。セッションの内容は、データベースが書き込み性能、I/O、強い一貫性という3つの壁をどのように乗り越えてきたのかを解説したものだ。ここでは、クラウドネイティブDBの進化をたどりながら、そこから導かれる分散システム設計の指針を紹介する。
クラウドネイティブDBを形づくる3つの壁と共通原則
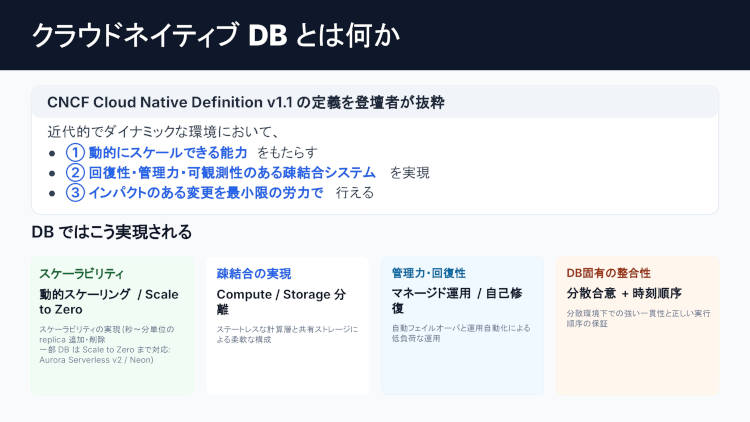
セッションの冒頭では「クラウドネイティブDBとは何か」が整理された。上田氏はCNCFの「Cloud Native Definition v1.1」から、動的にスケールできる能力、回復性・管理力・可観測性を備えた疎結合システム、インパクトのある変更を最小限の労力で行えること、という3点を取り上げた。
クラウドネイティブDBとは何か
これをデータベースに当てはめると、動的スケーリング、Compute/Storage分離、マネージド運用や自己修復、分散環境における整合性という4つの実装パターンに分解できる。
続いて上田氏は、聴講者を「急成長するSaaSのSRE/DBA」とするストーリーを設定した。単一プライマリのDBで運用するサービスが成長し、書き込みスループットが頭打ちになる。これ以上大きなインスタンスはなく、海外展開も視野に入れながら、現在と同等の整合性とレイテンシーを維持しなければならないという状況である。「海外展開も視野に、整合性は今のまま、レイテンシーも今くらいでと言われたとき、何を考えればよいのかをテーマとして持ってください」と上田氏は語った。
そこで現れるのが、「書き込みボトルネック」「I/O負荷とスケーリング」「分散下における強い一貫性」という3つの壁である。それぞれを解決するには、運用負荷、ネットワーク帯域、レイテンシーという代償も考えなければならない。
「制約はなくなりません。暗黙の前提を捨て、APIや構造として可視化し、責任を分離した上で、トレードオフを意図的に選んでいます」と上田氏は説明した。この「制約の明示化」「責任の分離」「トレードオフの選択」が、DBの進化を読み解く共通軸となる。
シャーディングの進化で書き込み限界をどう越えたか
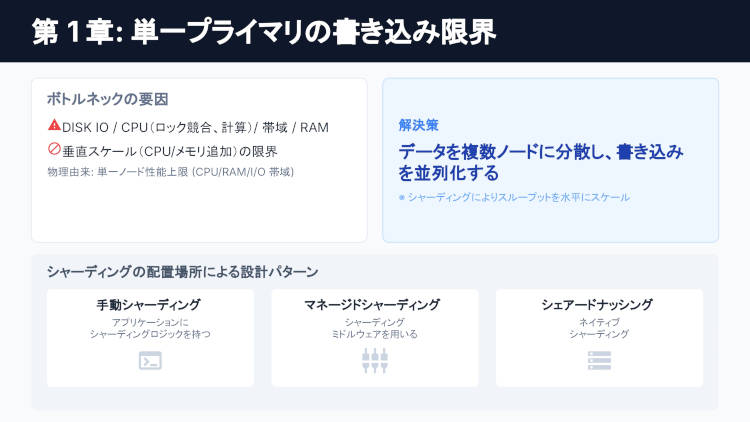
第1の壁は、単一プライマリにおける書き込み性能の限界である。ディスクI/OやCPU、メモリ、帯域には物理的な上限があるため、データを複数ノードへ分散し、書き込みを並列化する必要が生じる。
第1章:単一プライマリの書き込み限界
その代表的な方法がシャーディングである。上田氏は、その進化を手動シャーディング、マネージドシャーディング、シェアードナッシングの3段階で説明した。
手動シャーディングでは、アプリケーション側がシャードキーを計算し、データの配置先を決める。書き込みを水平にスケールでき、障害範囲も分離できる一方、クロスシャードJOINや分散トランザクション、透過的なリバランスは難しくなる。「シャードキーをアプリケーションで計算しているので、シャードの追加やリバランスは簡単ではありません。シャードキーの変更も事実上不可能になります」と上田氏は指摘した。
この複雑性をミドルウェアへ移したのが、マネージドシャーディングである。シャード管理をアプリケーションから隠蔽し、クエリルーティングやリバランスを自動化する。ただし、データの局所性設計は依然として必要であり、複数シャードをまたぐ処理では性能が低下する可能性もある。
さらに、DB自身がデータ分割や再配置を担うシェアードナッシング型へと進化した。データをrangeやregion、tabletといった単位に分割し、負荷や容量に応じて配置を自動的に変更する。
ここで起きた本質的な変化は、シャーディングの責任がアプリケーションからミドルウェア、さらにDB自身へ移ったことである。書き込み性能の物理的な限界は残るが、利用者がデータ配置を直接管理する負担は小さくなった。
Compute/Storage分離と強い一貫性の実現方法
第2の壁は、I/O負荷とスケーリングである。従来型のRDBMSでは、トランザクション処理、ログ出力、ページ書き込み、レプリケーションなど、多くの責任を単一インスタンスが担っていた。そのため、ログ処理やページ書き込み、レプリケーションに伴うI/Oが増幅し、レプリカを増やすほどプライマリ側の負荷も高まりやすかった。
これを解決したのが、ComputeとStorageの分離である。計算層と共有ストレージを分けることで、それぞれを需要に応じて独立してスケールできる。
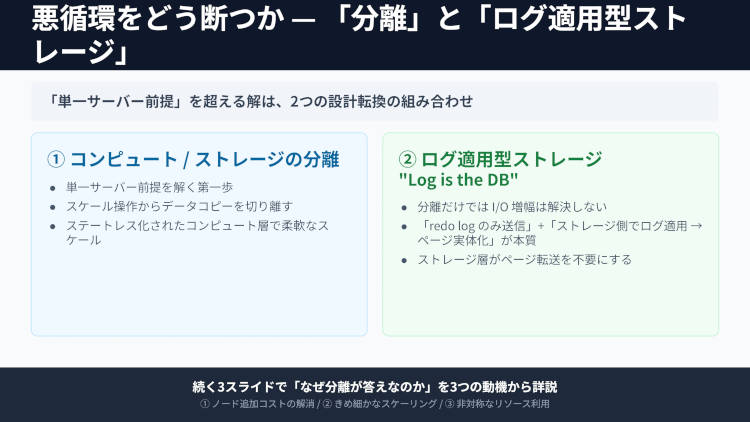
悪循環をどう断つか─「分離」と「ログ適用型ストレージ」
さらにAmazon Auroraが示したのが、「The Log is the Database」というログ適用型ストレージの考え方である。Compute側は変更後のページではなくredo logだけを送信し、Storage側がログからページを再構築する。
「ComputeとStorageを分けるだけではなく、ログからページを作る責任までStorage側に移しています」と上田氏は説明した。これにより、ネットワーク転送量を抑え、複製や自己修復の責任もStorage側へ移せる。
しかし、ComputeとStorageを分離しても、複数ノードにまたがるデータの整合性と実行順序は別の問題として残る。これが第3の壁である。
分散環境では、ネットワーク遅延や部分障害、ノードごとの時計のずれを避けられない。複数ノード間でトランザクションの実行順序を一致させるため、PaxosやRaftなどの分散合意アルゴリズムと、グローバルな順序づけが必要になる。
Google Spannerでは、TrueTime APIによって時刻の不確実性を区間として扱い、Commit Waitによってその期間が過ぎるまで待つことで外部整合性を実現している。
上田氏は、どれかの方式が一律に優れているのではなく、不確実性に伴うコストをどこで支払うかが異なると説明した。待機、リトライ、タイムスタンプ取得など、強い一貫性を得るための代償をどの形で受け入れるかが選択となる。
3つの指針から考える分散システムの選択基準
3つの壁を個別に見ると、書き込みスケールを解くシャーディングDB、I/O負荷を解くクラウドRDB、強い一貫性を解く分散KVSがある。それらを統合的に解こうとするのがNewSQLである。
ただし、NewSQLであればどれを選んでも同じというわけではない。データの分割単位、ストレージ構成、分散合意、順序づけなどは製品ごとに異なり、その代償も変わる。
上田氏は選定基準として、「書き込みスケール」「I/O・運用負荷」「強い一貫性」という3つの壁のうち、どこまでを解決する必要があるかを確認すべきだとした。3つすべてが必要ならNewSQLが選択肢になるが、必要な壁が2つ以下なら、既存のマネージドDBで十分な場合もある。
上田氏は、最強の解決策が存在するわけではなく、要件に応じて適切なトレードオフを選ぶことが重要だと強調した。
そして最後に示されたのが、「制約を明示化する」「責任を分離する」「トレードオフを選ぶ」という3つの指針である。上田氏は、これを分散システム設計に転用するため、5つの問いを示した。
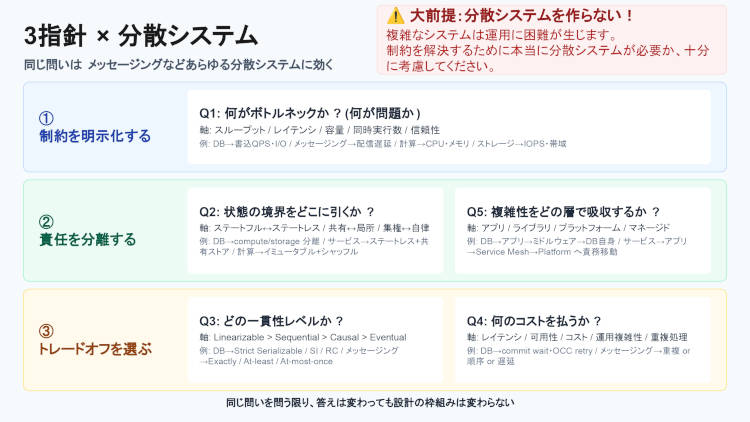
3指針×分散システム
「制約を明示化する」に対応するのが、「何をスケールするのか」である。書き込み、読み込み、容量など、解決したい制約を具体化しなければ、必要以上に複雑な構成を選ぶことになる。
「責任を分離する」では、「どこにデータを配置するのか」「誰が複雑性を引き受けるのか」を考える。単一regionか複数regionか、複雑性をベンダーに任せるのか、自社で運用するのかを決める必要がある。
「トレードオフを選ぶ」では「どの整合性が必要か」「何を犠牲にできるか」を問う。Strict Serializable、Snapshot Isolation、Read Committedのどれが必要なのか。その代償として、待機、リトライ、タイムスタンプ取得など、どのコストを許容できるかを判断する。
上田氏は「分散システムを作らないのが一番です」とした上で、本当に分散化が必要なのかを最初に確認すべきだと説明した。
セッションの最後には、3つの壁を越えてきたDBの進化が改めて整理された。書き込みボトルネックに対しては、シャーディングの責任をアプリケーションからDBへ移した。I/O負荷に対しては、ComputeとStorageを分離し、Storage側へ責任を移した。強い一貫性に対しては、時刻の不確実性を明示し、その代償として待機やリトライを選択した。
クラウドネイティブDBの歴史とは、制約を消した歴史ではない。制約を明示し、責任を適切な層へ移し、「何を得るために何を支払うのか」を意図的に選べるようにしてきた歴史なのである。
この記事をシェアしてください
バックナンバー


この記事の筆者

筆者の人気記事


Think ITでは、技術情報が詰まったメールマガジン「Think IT Weekly」の配信サービスを提供しています。メルマガ会員登録を済ませれば、メルマガだけでなく、さまざまな限定特典を入手できるようになります。