


Open Source Summit KoreaからAIの光と影を丁寧に解説するJim Zemlin氏のキーノートを紹介(後編)
Open Source Summit Korea 2026から、AIの光と影を丁寧に解説したJim Zemlin氏のキーノートを紹介する。
6:00
2026年8月11日と12日の2日間、韓国のソウルで開催されたOpen Source Summit Korea 2026のキーノートとして、The Linux FoundationのCEOであるJim Zemlin氏が行ったプレゼンテーションを紹介する。この稿では後半の部分、AIが産みだした影の部分を紹介する。
Open Source Summit KoreaからAIの光と影を丁寧に解説するJim Zemlin氏のキーノートを紹介(前編)
ここから始まるチャレンジに関する内容こそが、Jim Zemlin氏が最も伝えたかった内容だろう。ポイントは5つ、それぞれオープンデータ、デベロッパーの変化、オープンウェイトの制約、ハーネス、そして最後がセキュリティである。
5つのチャレンジを解説
オープンデータ
最初に挙げた問題はオープンなデータが少なくなっているという点だ。ここではインフラストラクチャーの下にデータをレイヤーとして追加して、ここがクローズドであると記載されている。
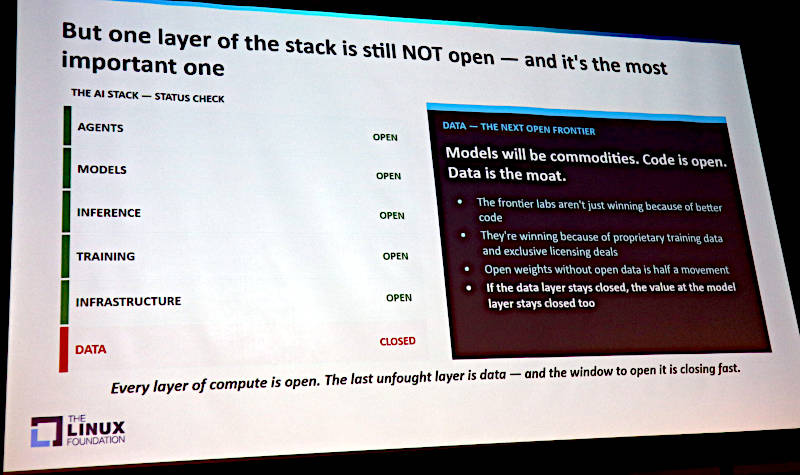
データレイヤーをインフラストラクチャーの下に追加。Closedと表記されている
このデータレイヤーがクローズドであることをさらに掘り下げたのが次のスライドだ。
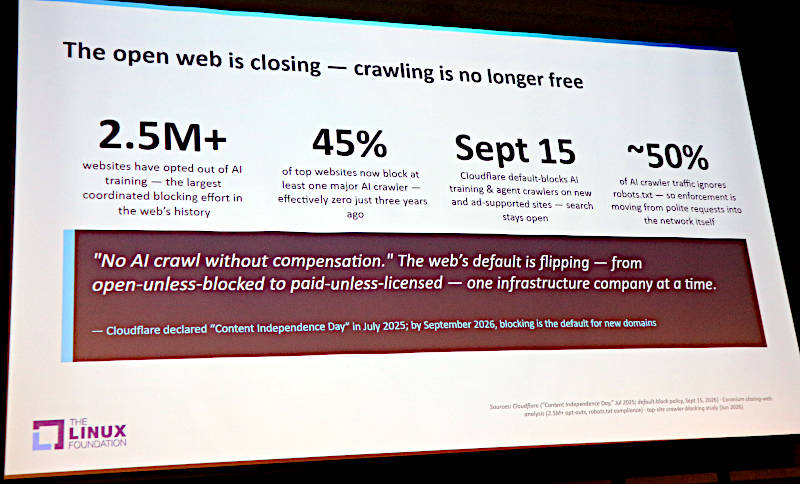
タイトルは「オープンなWebはなくなりつつある。クローリングはもはや無料ではない」
このスライドで取り上げられている「補填しないAIによるWebクローリングは許可しない」というのはCDNの大手、Cloudflareがこれまでの方針を変更して管理するドメインに対するBotのクローリングをデフォルトで禁止する設定を行ったキャンペーンを指している。このキャンペーンは2025年の7月1日に最初に行われた。初回当時はすべてのAI Crawl Botを禁止と設定、2026年の7月1日の2回目ではサーチを行うBotは許可、エージェントによるクローリング、モデル学習のためのクローリングは禁止という細かな設定に変更された。CloudflareはCDNではあるが、Bot/DDoS対策の最大手であるため、クローリングをエッジ側で制御する影響は相当に大きいと言える。
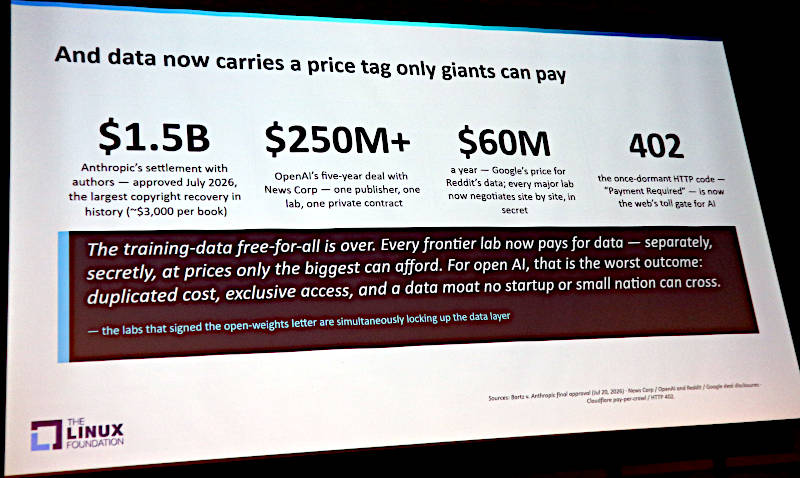
データには巨大な企業だけが支払うことができるプライスタグが付けられた
実際のところOpenAIやAnthropicなどの巨大なAIベンダーは、すでに大手のコンテンツホルダーに対してはデータに対して対価を支払っていると説明した。これまでのWebのコンテンツが検索を通じて無料で利用できるという状態だったのは、最終的にユーザーが検索されたサイトやページの広告を見るか、実際に購買などを通じて利益を生んでいたからに他ならない。しかし生成AIのBotはページをクロールしてコンテンツを貯め込み、ユーザーからの質問にクロールした情報を使って回答を返すが、ユーザーをコンテンツ先に送客しないという変化を指している。
Zemlin氏はこのような一部のAIベンダーによるデータ囲い込みが、オープンとは対極の寡占状態、重複した高いコストを発生させてしまうことを危惧しているのだ。AIベンダーがコンテンツホルダーと個別に契約を行うことでコストが高くなり、結果として生成AIユーザーにそのしわ寄せが来ることになる。
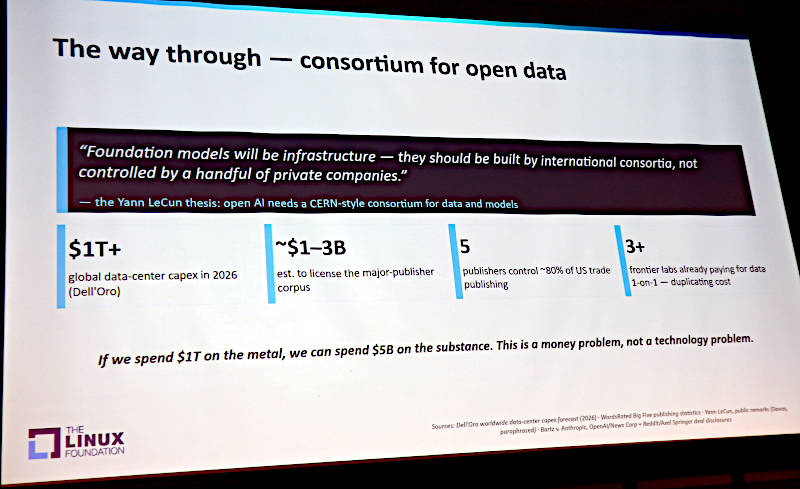
国際的なコンソーシアム形式でオープンなデータから生成されるモデルをインフラストラクチャーにせよ
このスライドで引用されている「少数の企業による寡占ではなく国際的なコンソーシアムでオープンなデータを使うインフラストラクチャーモデルを作れ」というのはNew York Universityの著名なAI研究者であるYann LeCun氏のコメントだ。LeCun氏はCERNのような国際的な枠組みの中でデータとモデルを利用、開発するべきだと述べている。
ここまでがデータがクローズドになり少数のメガベンダーに寡占されるという1つ目のチャレンジである。
デベロッパーの変化
ソフトウェア開発が根本的に変わったことが次のチャレンジ
影の部分の最初はAIが使うデータがオープンでなくなることだったが、2つ目のチャレンジはオープンソースのコミュニティへ直接的に関係する内容だ。これはAIがソースコードを書くのであればオープンソースのコミュニティにはどういう変化が起こるのか? という状況に由来する課題となる。
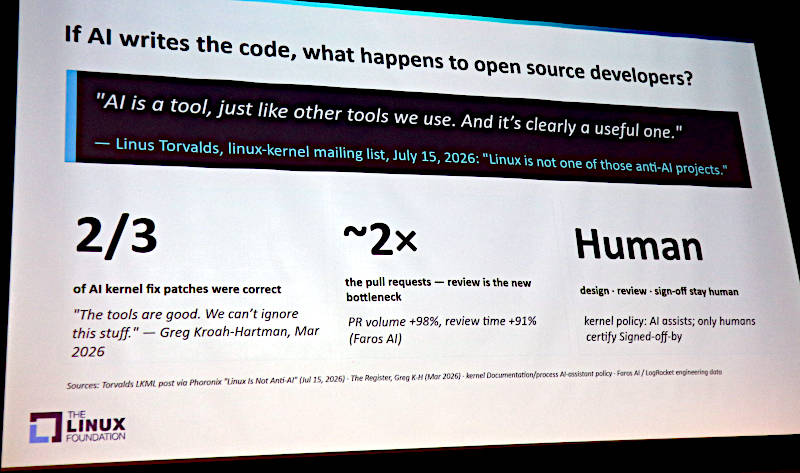
もしもAIがコードを書いたら何が起こる?
ここではLinuxの創始者Linus Torvalds氏が2026年7月15日にメーリングリストに投稿した内容を引用している。それは「AIはツールであり、我々が使っている他のツールと何も変わらない。そしてツールの中ではかなり有用である」というものだ。Linuxの開発者にとってAIは敵対視するものではないことを明確に認めている点を強調している。その上でAIが生成するコードが高品質になっていることに対してレビューを行うコストは変わらず、コードの量が増えただけレビューを行う人間がボトルネックになっていることを示している。デザインやレビュー、最終的にそのコードをマージするかどうかの判断は人間に委ねられていることは変わらない。
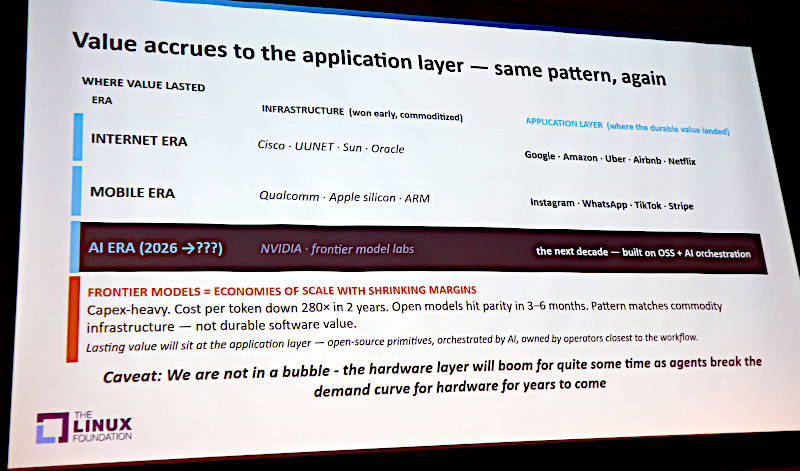
AIの革新はインターネット、モバイルで起きた革新と同じ性格を持つ
このスライドでは過去にインターネットやモバイルデバイスで起きた革新と同じことが起きていると説明。つまり初期にはハードウェアなどのインフラストラクチャーに価値が集約されるが、ユーザーが要求する価値はアプリケーションレイヤーに移動し、インフラストラクチャーそのものでは大きな価値は発生しない。例としてインターネットではCiscoやSun、Oracleなど、モバイルではQualcomm、Apple Silicon、ARMなどが、革新初期に価値を創りだしたとしてもすぐにGoogleやAmazon、Uberなどが主要な価値を作り出すプレイヤーとなり、モバイルにおいてもInstagram、TikTokなどがユーザーや企業にとって価値を生み出すプレイヤーになることを示している。
ではAIにおいてはどうか? 初期の価値はNVIDIAやフロンティアモデルを作り出すAIベンダーであり、より多くの価値を生み出すアプリケーションレイヤーではオープンソースとオーケストレーションを行うソフトウェアになると予想している。このスライドではAIがコードを書き人間がレビューをするというアンバランスやアプリケーションレイヤーで何が価値を生み出だすのか? という点には触れず、単にハードウェアはコモディティになる、アプリケーションが勝負の場だ、と予想しているだけだ。アンバランスという点に関しては最後のセキュリティのチャレンジのところで解説されるAkritesが一つの回答になるということだろう。
オープンウェイトの制約
オープンウェイトモデルに関する制約が3つ目のチャレンジ
次のチャレンジは、オープンウェイトの制約に関するものだ。
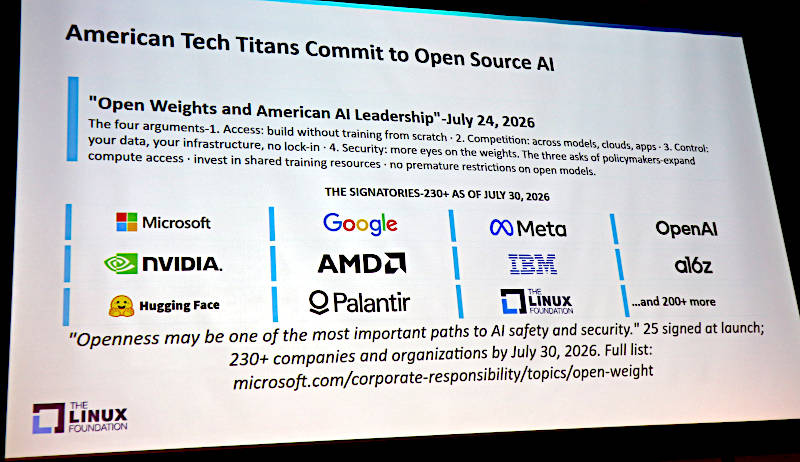
オープンソースによるAIについてのアメリカ側の回答
このスライドでは2026年7月24日にMicrosoftが公開したアナウンスをベースに解説している。
●参考:Open Weights and American AI Leadership
このアナウンスには270社以上の企業がこのオープンウェイトによるAIに賛同していることが示されている。企業としてAmazon、Cloudflare、Google、Meta、Microsoft/GitHub、OpenAI、NVIDIA、IBMなど主要なベンダーが賛同しており、ユーザーも含めて多くのアメリカ企業が揃って支持している。よって、これが政府に提案されるオープンモデルAIのあるべき姿になる可能性は強い。しかしアメリカには著作権で守られる知的財産が多数存在し、AIによって無差別に学習され再利用されることを拒否する企業も多い。この課題では、イノベーションを止めないために「オープンなAIを作れ」と言いながら、同時に知的財産を守るにはどうしたらよいのか? という観点が抜けていることに留意したい。
オープンウェイトについてはMetaのMark Zuckerberg氏のコメントも紹介しながら、オープンウェイトのAIがすべての利用者、開発者に対して公開されることでイノベーションを進展させることが必要であると強調した。
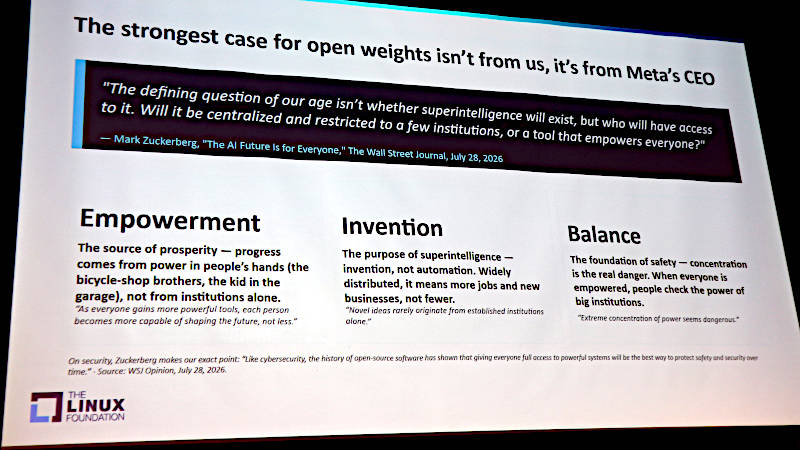
MetaのCEO、Mark Zuckerberg氏のコメントを紹介
ハーネス
次のチャレンジはハーネスだ。これからのビジネスの現場での競争はどのモデルが良いのか? という点から「ハーネスをどうやって作るのか?」に移るというものだ。
フロンティアモデルの競争からモデルを制御するハーネスが競争の中心となる
このスライドで紹介しているハーネスとは何か? これについては「モデルの回りにあるすべてのものがハーネスである」というやや乱暴な定義だが、内容豊富なこのセッションの中では必要十分な定義だろう。
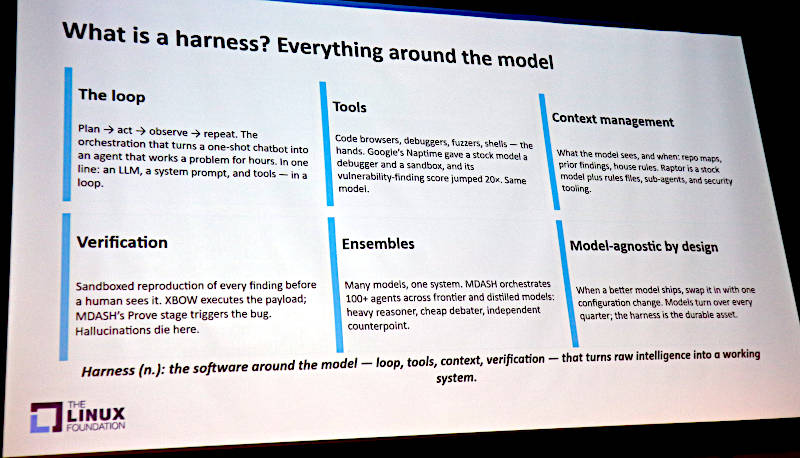
ハーネスとはモデルの回りにあるすべてのものを指す
モデルとエージェントによって構成される推論とアクションのループ、利用されるツール、コンテンツ管理、検証、複数のモデルを協調する仕組み、モデルに依存しないアーキテクチャーなどが例として挙げられている。検証と協調の部分で、Microsoftが2026年のBuildで発表したMDASHが挙げられているのは興味深い点だ。
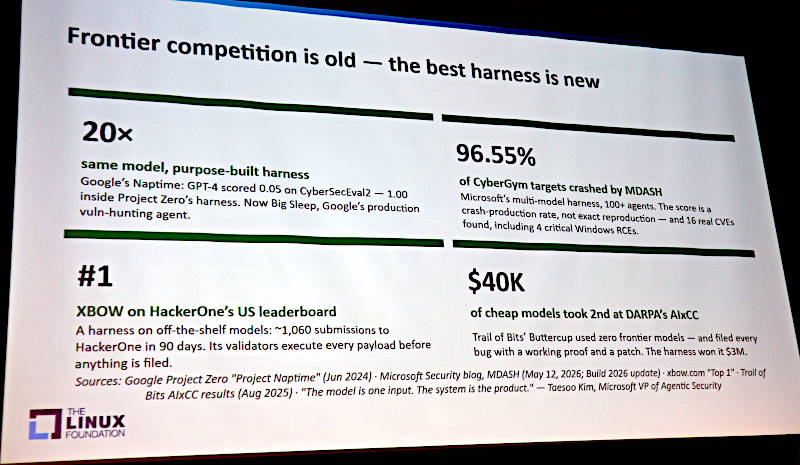
フロンティアモデルから競争はハーネスに移行している
さまざまなモデルがその性能を競う中で同じモデルであってもハーネスによって性能が大きく異なること、ハーネスによって脆弱性発見の性能が異なることなどをいくつかの例を挙げて説明しているが、1枚のスライドで語るには内容が多過ぎる。Zemlin氏は多くの傍証を挙げることで、モデルがコモディティ化した結果、ハーネスの違いによる競争に移ったことを印象として示したかったと思われる。ここで挙げられているハーネスの例はプロプライエタリなソフトウェアであるため、次のスライドでオープンソースコミュニティに開発を促していた。
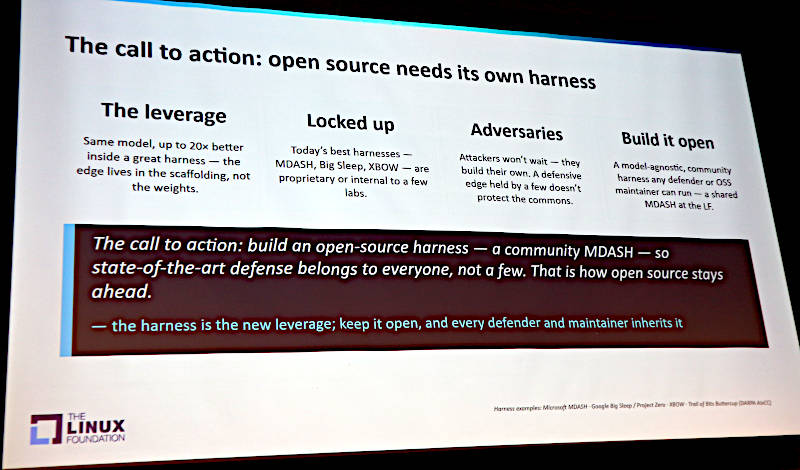
オープンソースによるハーネスの開発をコミュニティに訴える
ここではCall to Action、つまり行動を起こして欲しいと訴えているが、そのためのきっかけとなる具体的なものが示されていない。行動を起こせと訴えるだけでその方法はコミュニティに任せるという発想だろうか。
セキュリティ
最後のチャレンジはサイバーセキュリティ。
5つのチャレンジの最後はセキュリティに関する内容だ。セキュリティには多くの領域があるが、AIによって大量に発見される脆弱性への対応が最大の課題になっていることをAnthropicのコメントを使って紹介している。
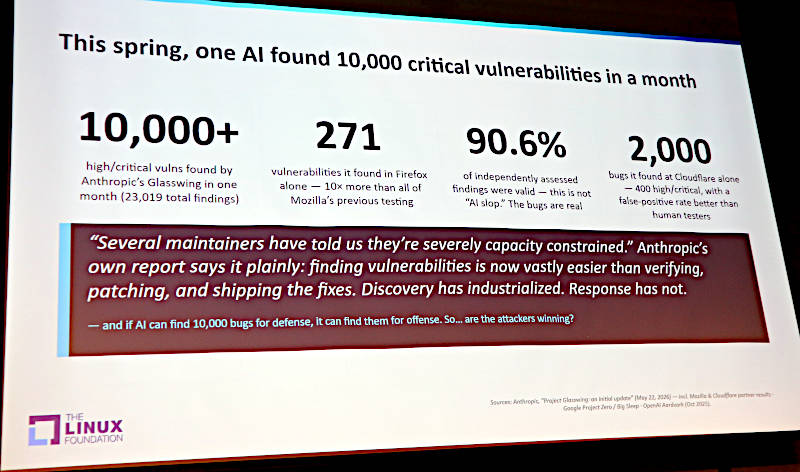
AIによって脆弱性を発見することは問題ではなく、それをレビューして承認する労力が問題
ここではAnthropicのGlasswingが1ヶ月で1万件を超える脆弱性を発見したこと、そしてもはやそれらの発見はAI Slop(AIによって生成されるゴミのような脆弱性)ではなく本物のバグであるという。
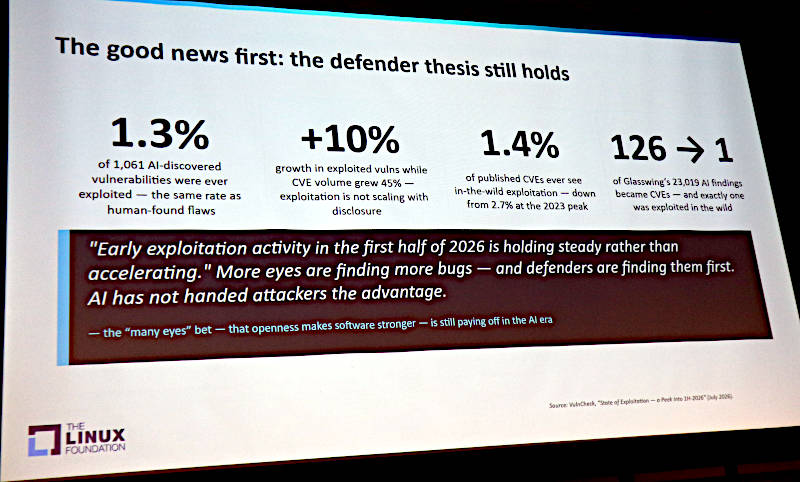
発見された脆弱性が攻撃者によって使われる傾向は減っている
もっとも、AIが発見した本物の脆弱性が攻撃者によって利用されることは少なく、守る側が攻撃する側を先行している。この点は良いニュースとして紹介された。ここではLinusの法則、すなわち「Given enough eyeballs, all bugs are shallow」を引用して、この法則がAIの時代にも通用していることを示している。
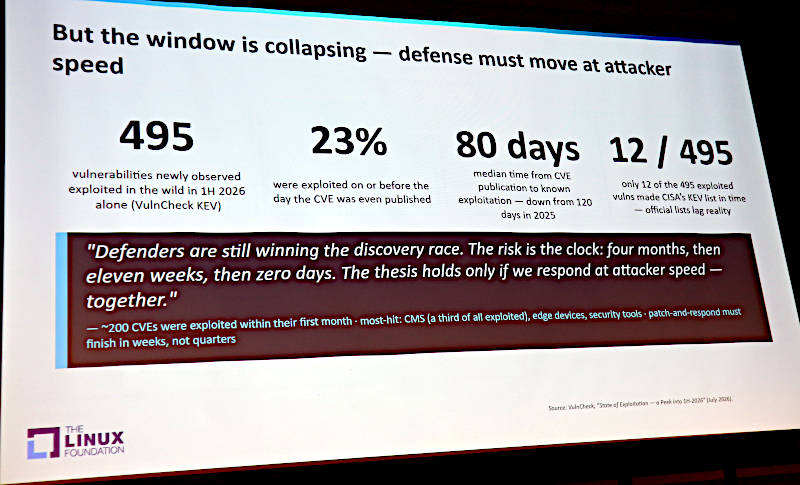
攻撃者側が脆弱性に対してゼロディ攻撃を行う確率は高まっている
しかし攻撃者側もAIを使って常に攻撃を行って利益を得る手法を模索していることは変わらない。実際、攻撃者の脆弱性発見から攻撃に用いるまでのタイムラグは毎年減少している。2025年にはこの間隔は120日であったものが、2026年では80日となっており、大幅に短くなっていることを示した。
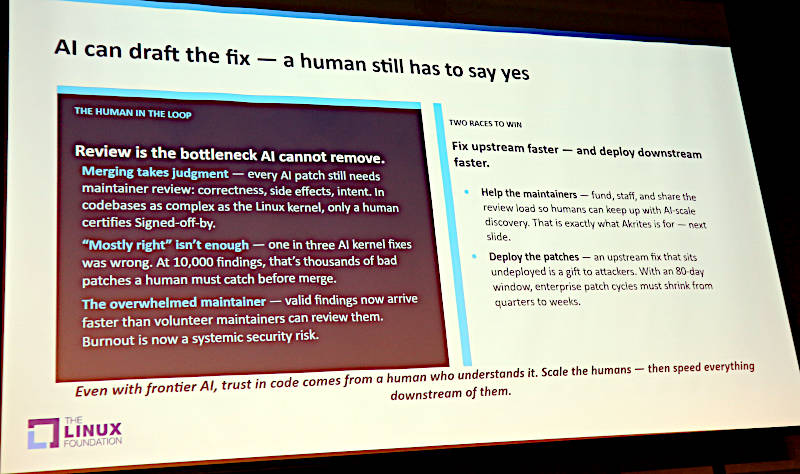
AIは脆弱性の修正を生成できるが、ボトルネックは修正をレビューする人間
これはセッションの前半のAIの良い部分、光の部分では語られなかった内容だ。AIはコードの修正はできるが、レビュープロセス自体をAIが代替することは未だできていないと説明している。解決策としてはメンテナーを支援しよう、マージされたパッチは即座に本番環境に実装して攻撃者に時間的余裕を与えないようにしよう、という2点だけが挙げられている。
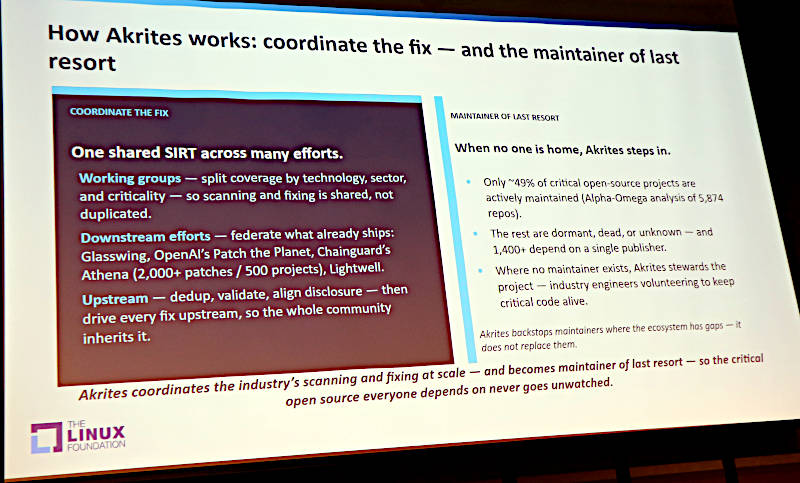
Akritesで構造的な問題の一部は解決できるが、レビュワーの労力を下げることには部分的効果
ここで紹介されているLFのプロジェクトAkritesは、LFが2026年6月25日に発表した新しいプロジェクトである。
Akritesの目的は大量に発生する修正のレポート経路を調整し、アクティブなメンテナーが存在しないプロジェクトに対して人的なリソースを提供することで、脆弱性が見つかったがマージして最新版を作る人がいないという問題を解決するものだ。そのために企業が資金と人的リソースを提供して具体的に行動を起こすという部分がポイントだ。これはすでに動いているプロジェクト、AnthropicのGlasswingやChainguardのAthenaと連携して動くことと、IT業界だけではなくユーザー企業も交えて稼働することが大きな違いとなる。
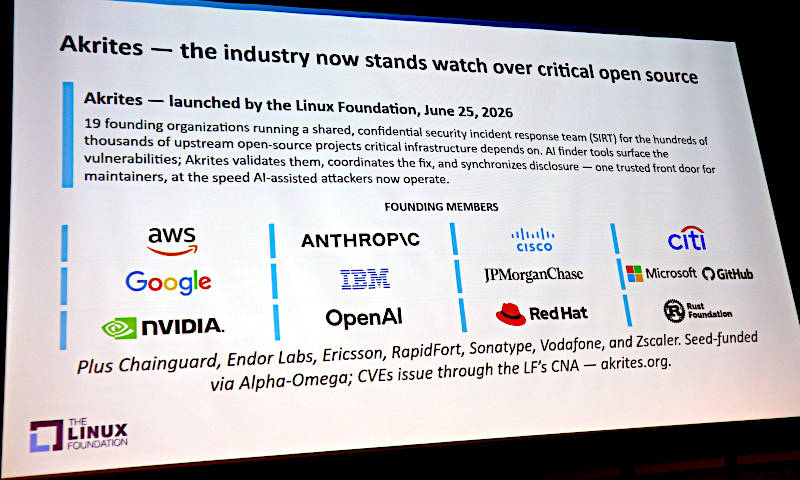
AkritesのメンバーにはIT企業だけではなくCitiやJPMorganChaseなども含まれる
Akritesはオープンソースメンテナーのレビューにかかる労力を直接的には削減しない。またAkritesによって救済されるプロジェクトもAkritesプロジェクトの中で決定されるため「今困っているから助けて欲しい」というプロジェクト側の声に応えることはできない。しかし何もしないよりは遥かに良い行いだし、実質的に動き出す2026年の秋以降にその成果を検証し、そのうえで評価する必要があるだろう。
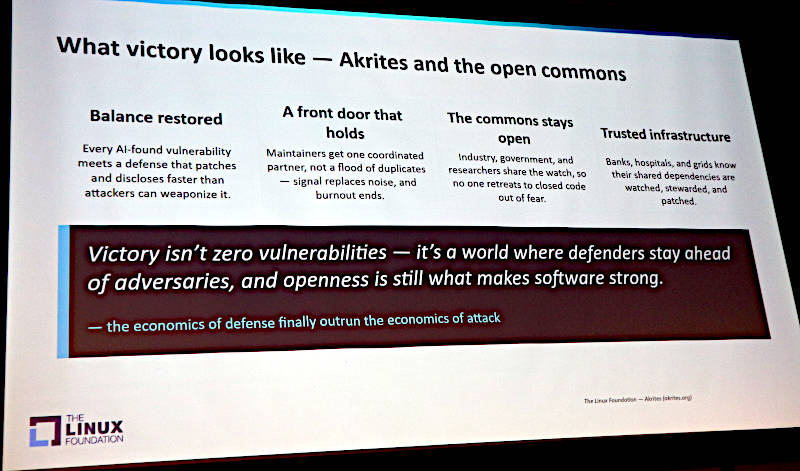
Akritesが効果を与えることで修正とレビューのバランスが元に戻る?
このスライドではAkritesが成果を出すことで脆弱性が発見されれば、メンテナーが少ないクリティカルなプロジェクトは救済され、社会のインフラストラクチャーを担うソフトウェアが安全になることを示しているが、これはあくまでもAkritesが機能した場合という想定に過ぎない。「理想的な姿はバグがゼロになることではなく、防御を行う側が攻撃する側に先行してオープンであることが保たれることだ」この考えは確かに理想的だが、実現するのは困難だろう。
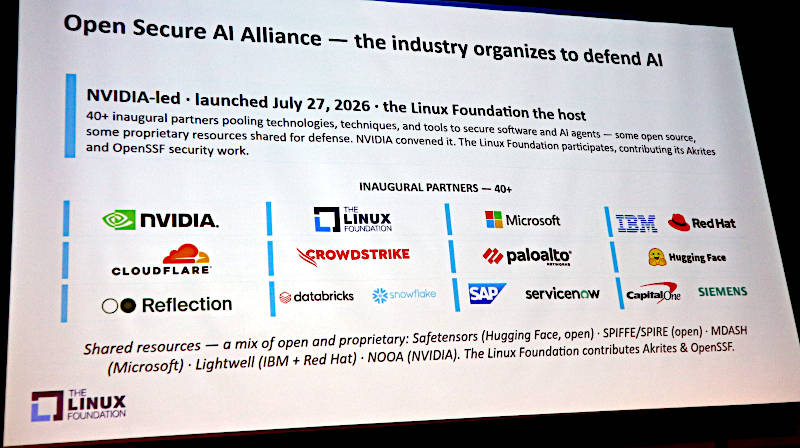
オープンでセキュアなAIを作るためのアライアンスを結成
最後のスライドはNVIDIAがリードし、LFがホストする新しいアライアンスOpen Secure AI Allianceを紹介。詳しくはNVIDIAの発表文を参照して欲しい。
●参考:業界のリーダー企業が、AI の安全性とセキュリティ向上のためOpen Secure AI Alliance を結成
ここまでAIの光と影をかなり詳しく解説してきたZemlin氏のセッションを紹介した。ポイントはLF/CNCFがスモールモデルをオンプレミスで実装することを推奨していること、オープンソースのハーネスを開発することを呼びかけたことだろう。AIがコードを書くことでレビュワーが疲弊してしまう問題は繰り返し取り上げているが、まだ決定的な解決策がないというのが正直なところだろう。今後、AkritesとNVIDIA主導のアライアンスが何をするのかを注意深く観察していきたい。
この記事をシェアしてください
関連記事

【KubeCon Japan 2026】LFの新プロジェクトAkritesの概要をJim Zemlinの解説から紹介
11月6日 5:59

KubeCon+CloudNativeCon China 2025開催、初日のキーノートセッションを紹介
2025年9月2日 6:00

LFが欧州OSSと低品質AI生成PRを指す「AIスロップ」問題の2つのレポートを公開、OSERAは100日で本格稼働、ほか
10月30日 6:30

Red Hat Summit 2024、Red HatのAI戦略を読み解く
2024年7月11日 6:00

LFが「Tokenomics Foundation」を発足、「KubeCon Japan 2026」ではAIフルスタックが本番対応に、ほか
8月31日 6:30

LFとOpenSSF、OSSのセキュリティを向上させる具体的な計画を日本で発表
2022年12月1日 6:00
バックナンバー


この記事の筆者

筆者の人気記事

マニュライフ生命のAIの責任者にインタビュー。全社員がAIを使いこなすAI for Allとは?
10月2日 6:00

【OSS Summit North America 2026】Netflixのエンジニアが開発したコンテキストを圧縮するオープンソース、Headroomを紹介
10月9日 6:00

【KubeCon Japan】KubeCon Japan 2026開催。オープンなAIを推奨する初日のキーノートを紹介
10月23日 5:59

【OSS Summit North America 2026】ドローンのグラウンドコントロールシステムであるQGC(QGroundControl)に関するセッションを紹介
11月4日 6:00

LF Energyがミートアップを実施。ヨーロッパとの違いが際立ったプレゼンテーションを紹介
10月6日 6:00

【KubeCon Japan】CNCFのリサーチ「クラウドネイティブ開発の現状」から見える日本のITが抱える問題点を考察する
10月7日 6:00
Think ITでは、技術情報が詰まったメールマガジン「Think IT Weekly」の配信サービスを提供しています。メルマガ会員登録を済ませれば、メルマガだけでなく、さまざまな限定特典を入手できるようになります。

