【OSS Summit North America 2026】Netflixのエンジニアが開発したコンテキストを圧縮するオープンソース、Headroomを紹介
Open Source Summit North America 2026から、Netflixのエンジニアが開発したコンテキストを圧縮するオープンソース、Headroomを解説したセッションを紹介する。
6:00
2026年5月18日から20日の3日間、ミネソタのミネアポリスで開催されたOpen Source Summit North America 2026から、Netflixのエンジニアが解説するHeadroomというオープンソースソフトウェアを紹介する。セッションのタイトルは「Headroom: A Context Optimization Layer for LLM Applications」プレゼンテーションを行ったのはNetflixのTejas Chopra氏だ。動画は以下から視聴できる。
●動画:Headroom: A Context Optimization Layer for LLM Applications
Chopra氏のLinkedInによると2026年6月でNetflixを離れたことになっているが、このカンファレンスが行われた5月の段階ではNetflixの一員であったということだろう。所属はMachine Learning Platform Groupということから、Netflixにおける機械学習や大規模言語モデルの中核にいた人材であることがわかる。個人のデベロッパーとしてClaudeへの毎月の支払いが300ドル近くになった時にこの問題を何とかしないといけないと気付いたという。
Headroomはコンテキストを圧縮するレイヤーとして、LLMにデータが送られる前にコンテキストを圧縮してコストを抑えるというライブラリーのようだ。
コンテキスト圧縮するレイヤー(実際にはライブラリーである)
大規模言語モデルはコーディングからチャットによる議論まで多くのタスクをこなせるようになっており、Chopra氏もClaude CodeやCursorなどを日常で使っていると説明。しかしここで大きな問題があるとして挙げたのはそのコストだ。このスライドではToken Taxと表現されているが、使えば使うほどコストが発生するというのが大規模言語モデルの大きな障害になっているという。
トークンを大量に使うことで巨大なコストが発生する
大規模言語モデルはコーディングアシスタントであればAPI課金、チャットであればチャットの往復が重なるほどにそのチャットの内容が毎回送られることになる。大規模言語モデルがWeb検索などを行う際に内部で生成される検索ワードや異なるサイトへのアクセスなど、シンプルな質問をしたつもりでも大量のトークンが使用されることになる。またエラーログをコンテキストとして入力し、原因を探索するような使い方でもエラーログのデータの量によってコストが発生してしまう。
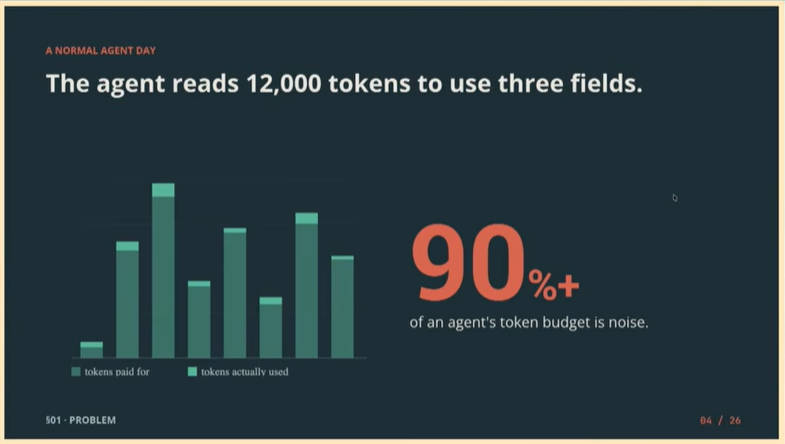
90%のトークンは推論に使われずノイズとなってしまう
このスライドではその根拠が示されていないのが残念だが、トークンの90%はノイズとして推論には使われていないと解説した。
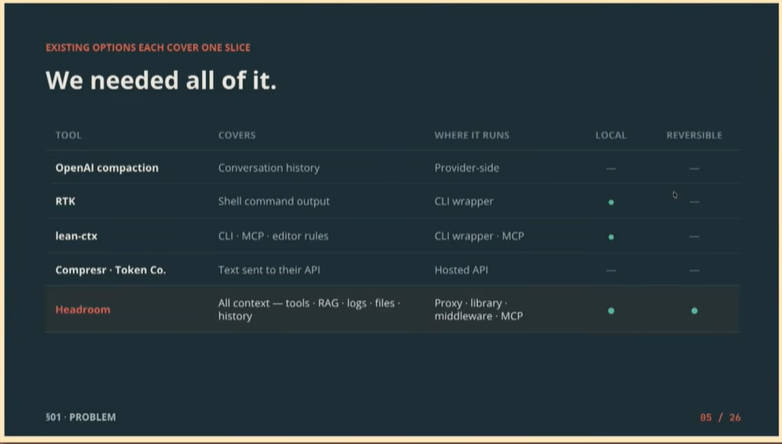
トークンを圧縮するためにさまざまなツールが開発されている
ここでOpenAIやRTKなどのトークン圧縮ツールを紹介。それらのツールと同じカテゴリーにいるのが、Chopra氏が開発したオープンソースソフトウェア、Headroomだ。この比較表ではクラウドサービス側で実行されるパターンとコマンドラインをラップしてローカルで圧縮するパターンの2つが示されているが、Headroomが特徴的なのか、Reversibleであることだろう。Reversibleについては後でデモを含めて紹介される。
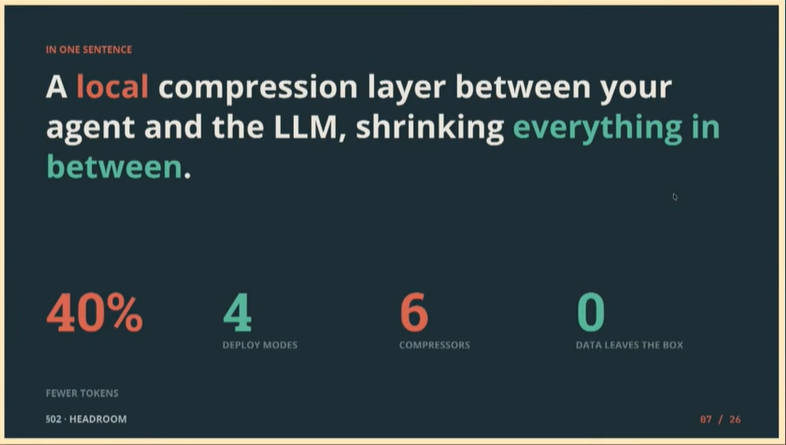
ローカルで圧縮を行うHeadroom。エージェントとLLM間のデータをすべて圧縮
Headroomのアーキテクチャーを説明したスライドでは、Headroomの4つのコンポーネントを解説している。ここではCache Aligner、ContentRouter、ContextHitそしてCCR(Compress-Cache-Retrieve)だ。SmartCrusherは統計的にトークンを圧縮、CacheAlignerはキャッシュにヒットしやすいように動的に変化するデータ(日付など)を削除し、ContentRouterはLLMに送られるデータのタイプによって呼び出される圧縮ツールを選択、ContextHit(ドキュメントではIntelligentContextと表記)がトークンの最大サイズに収まるようにデータを優先順位付けして優先度の高いデータを送り、トークンサイズを超えてしまうような場合は優先度の低いデータをドロップするという仕組みになっている。
より詳細にはHeadroomのドキュメントを参照して欲しい。
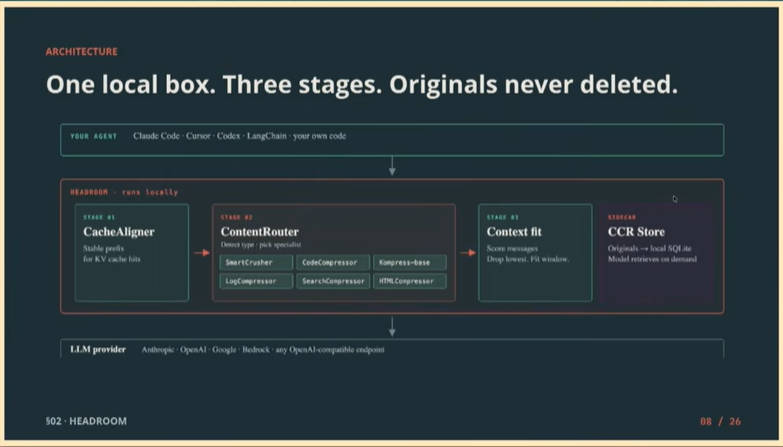
Headroomのアーキテクチャー。オリジナルのコンテキストはすべて保存される
このスライドにあるように、オリジナルのトークンは必ず保存され、必要に応じて再利用することができると説明している。この圧縮する前のコンテキストを保存しておいて必要な場合は取り出せるというのが単なる圧縮ツールではないポイントだろう。機械的に圧縮するだけではLLMへのトークンが意図しない形に圧縮され、結果的にデベロッパーが望む結果が得られないということを防ぎたいというChopra氏の意図が感じられる。
ちなみにHeadroomはNetflixからスポンサーされているわけでもなく、Netflixの社内で公式に認められたツールでもないことはChopra氏のブログに明記されている。
●参考:I Looked at My Claude Bill. 90% Was Tokens I Didn't Need.
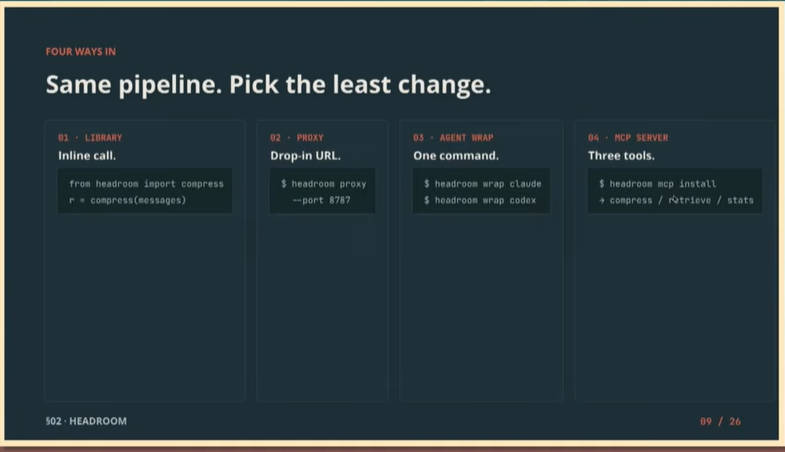
Headroomの使い方
Headroomの使い方を説明。ここではソースコードから呼び出し、Proxyとして使う方法、エージェントをラップする方法そしてMCPサーバーとして実装するなど使い方はさまざまだ。
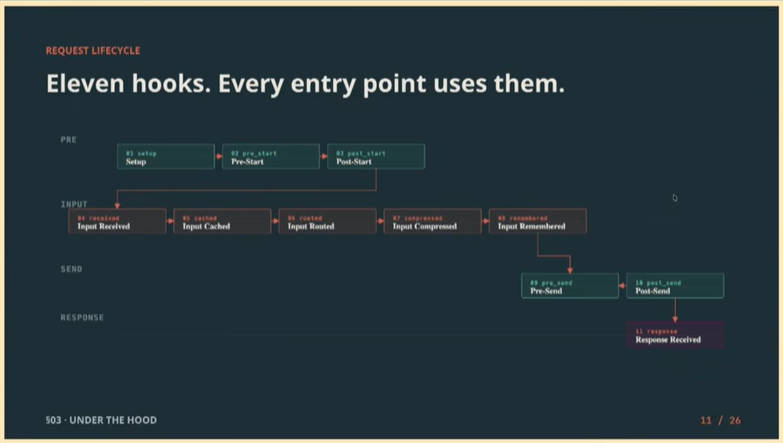
トークンが送られるまでの処理を説明
統計的にデータを圧縮する方法からデータの種類に応じて圧縮するツールを呼び出して実行、最終的にLLMに送られるまでの流れを解説している。
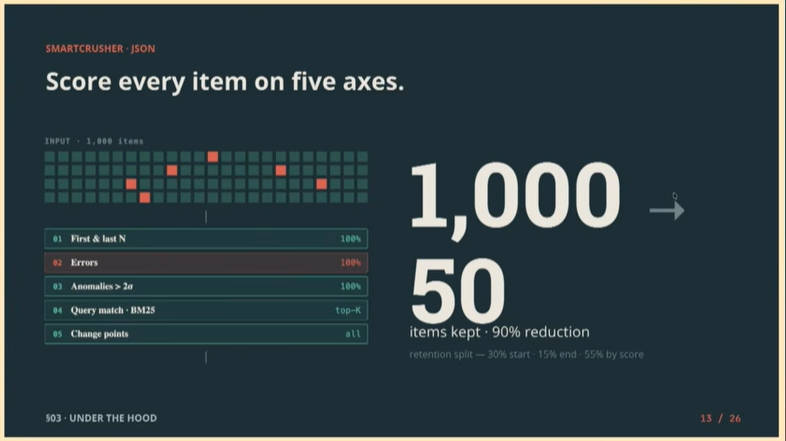
最初にトークンを統計的に圧縮するSmartCrusherを解説
ここでは1000個のアイテムから構成されるJSONなどのデータが50個程度に圧縮されることを説明。
ソースコードの圧縮を説明
この部分についてはTree-Sitterを使ってソースコードの構文の関係性を抽象構文木として解析を行うと説明されている。
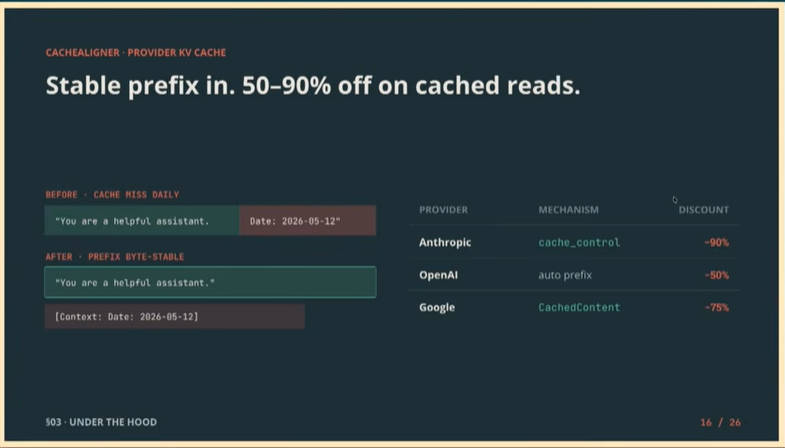
キャッシュにヒットしやすい構文に変更するツール
ここではKVキャッシュにヒットしやすいように日付や時間のようなユニークに変わってしまうデータと、本来LLMに渡したいトークンを分離することでキャッシュへのヒット率を上げる仕組みを紹介している。
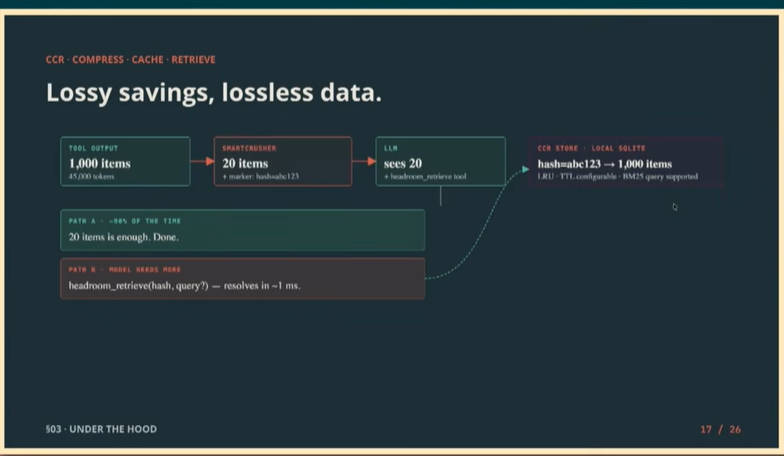
CCR(Compress-Cache-Retrieve)の仕組みを解説
圧縮されたトークンだけがLLMに送られるのではなく、圧縮前のトークンも保存しておいて必要に応じて取り出せるという仕組みがCCRだ。
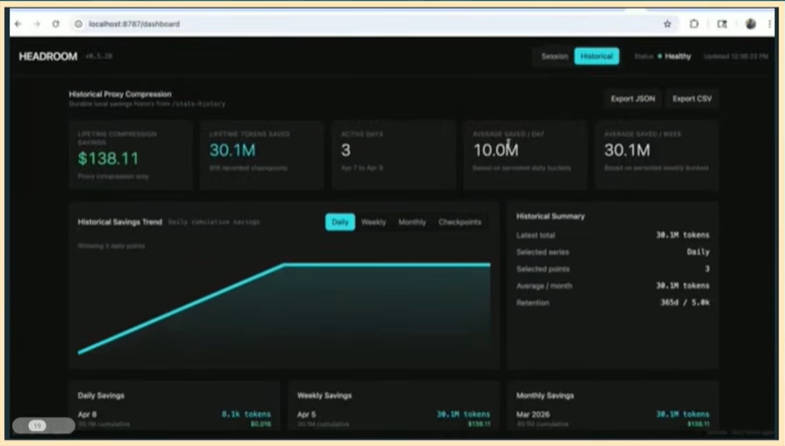
HeadroomのWebUIを説明
ここからはデモの動画を使って実際にダッシュボードを見せたり、Claude Codeのコマンドラインを使って実際にトークンが圧縮されているようすを説明したりした。
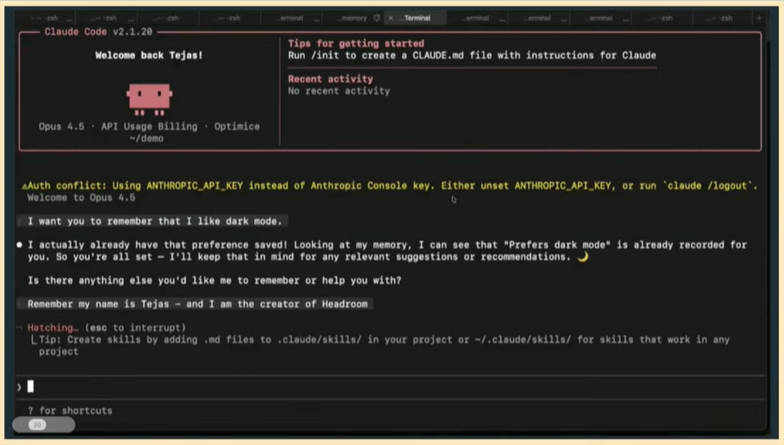
Claude Codeのコマンドラインを見せて操作を説明
Headroomによる圧縮については以下のようなデータがドキュメントサイトに掲載されている。
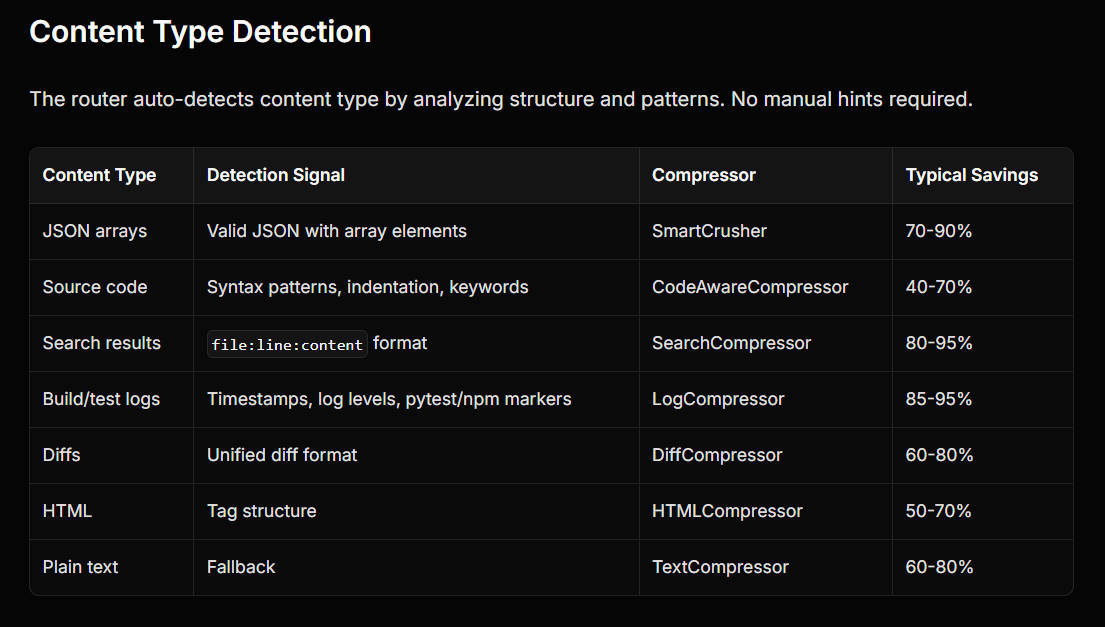
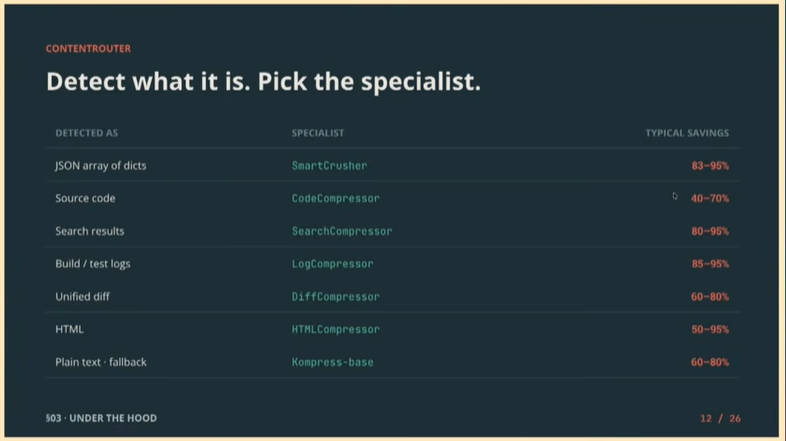
それぞれのデータタイプによって呼び出されるContentRouterが異なる
データタイプによって呼び出されるContentRouterが異なり、JSONであればSmartCrusher、ソースコードであれば構文解析を行った上で本文を折りたたむなどの工夫がなされている。
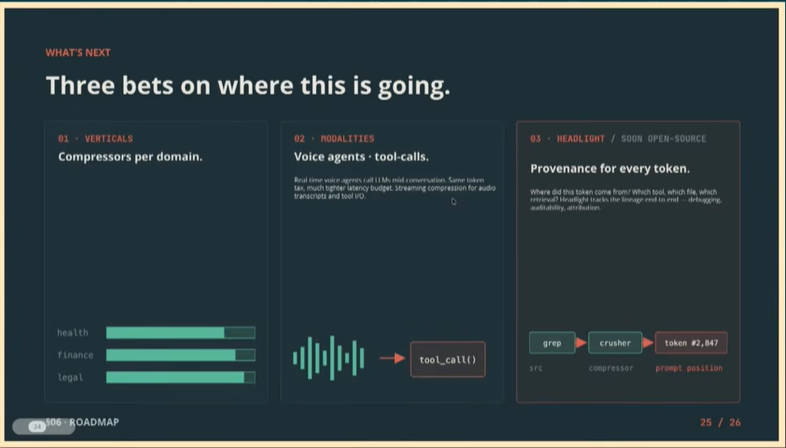
今後の開発計画を紹介
このスライドでは今後の予定を簡単に紹介している。データのタイプだけではなく産業ごとに最適なトークン圧縮を採用すること、音声などのマルチモーダル化、テレメトリーデータをLLMに読ませる時の圧縮についてはHeadlightと呼ばれるプロジェクトが立ち上がる予定であると解説した。
全体的に自身が必要なツールを作り、公開したといういわゆる草の根的なオープンソースプロジェクトだが、初期の成功がそのままメンテナーの負担になってしまうという悪い循環から逃げられるのかどうかがポイントだろう。これからさまざまなツールがクラウドベンダー側からも出てくることを想定すると、このプロジェクトが継続するためには資金力があり、オープンソースへの貢献を継続できる企業にacqui-hire※してもらうことが最善の方法であるように思える。
※ acqui-hire:acquisition(買収)とhire(雇用)を組み合わせた造語で、「人材確保を目的とした買収」の意。日本語での表記・読み方は「アクハイヤー」など。
●公式GitHubページ:https://github.com/headroomlabs-ai/headroom
この記事をシェアしてください
関連記事

KubeCon Europe 2026から生成AIの推論をテーマにしたキーノートセッションを紹介
7月1日 6:01

KubeCon North America 2025、ユーザー4社が相乗りしたキーノートセッションを紹介
2月6日 6:00

人工知能分野で著名なYann LeCun氏教授の世界モデル(JEPA)を解説する動画を紹介
8月21日 6:00

KubeCon Europe 2026、AIがコードを書く時代にはコードではなくコンテキストが重要になると訴求するセッションを紹介
6月26日 5:59

API GatewayのKongがニューヨークでテックカンファレンスを開催。初日のキーノートを紹介
2025年12月12日 6:00

LFが「Open Source Summit North America 2026」を開催、AI導入の実態を調査した「2026 State of Tech Talent Report」を公開
5月29日 6:30
バックナンバー

この記事の筆者

筆者の人気記事


Think ITでは、技術情報が詰まったメールマガジン「Think IT Weekly」の配信サービスを提供しています。メルマガ会員登録を済ませれば、メルマガだけでなく、さまざまな限定特典を入手できるようになります。