


KubeCon China 2026がPyTorch Conference、OpenInfra Summit Asiaと同時開催。クラウドネイティブと生成AIが交わる交差点をキーノートから紹介
KubeCon+CloudNativeCon China 2026がPyTorch Con、OpenInfra Summit Asiaと同時開催された。クラウドネイティブと生成AIが交わる交差点をキーノートから紹介する。
6:00
KubeCon+CloudNativeCon China 2026が2026年9月7日から9日の3日間、中国の上海で開催された。このカンファレンスはOpenStackやKata ContainersなどのプロジェクトのプロジェクトをホストするOpenInfra Summit Asiaと、機械学習のフレームワークであるPyTorchが主軸のPyTorch Conferenceと同時開催となった初めてのカンファレンスである。正式名称もKubeCon+CloudNativeCon+OpenInfra Summit+PyTorch Conference China 2026という長大なものになっている。
総論的に言えば、3日間のカンファレンスではクラウドネイティブなシステムに加えて機械学習に特化したセッションも混在することで、これまでのKubeConやOpenInfra Summitだけでは聞けなかった内容が紹介されていることが特徴的であった。
この稿では初日のキーノートセッションの内容を紹介する。
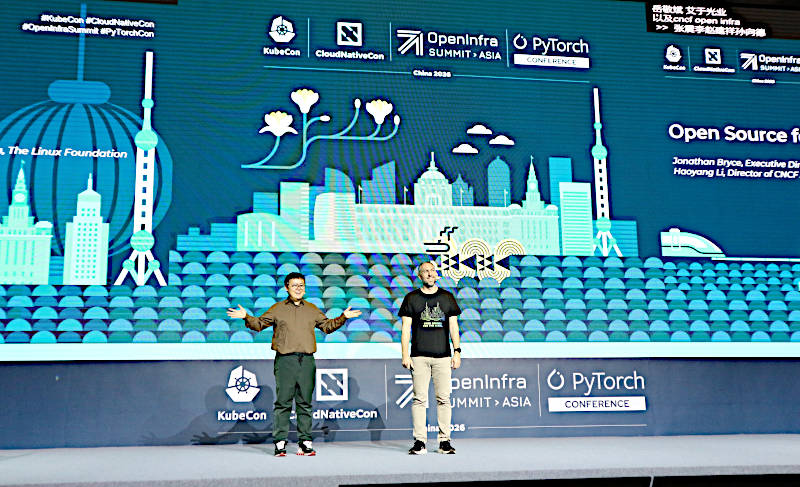
MC役はCNCFのエグゼクティブディレクターのJonathan Bryce氏(右)とCNCF AsiaのディレクターであるHorace Li氏(左)だ
カンファレンスでは英語と中国語のプレゼンテーションが混在していたのを象徴するように、CNCFのJonathan Bryce氏が英語で、CNCF AsiaのHorace Li氏が中国語でMC役としてキーノートを開始した。ここでの中心的な話題はやはりAIだ。
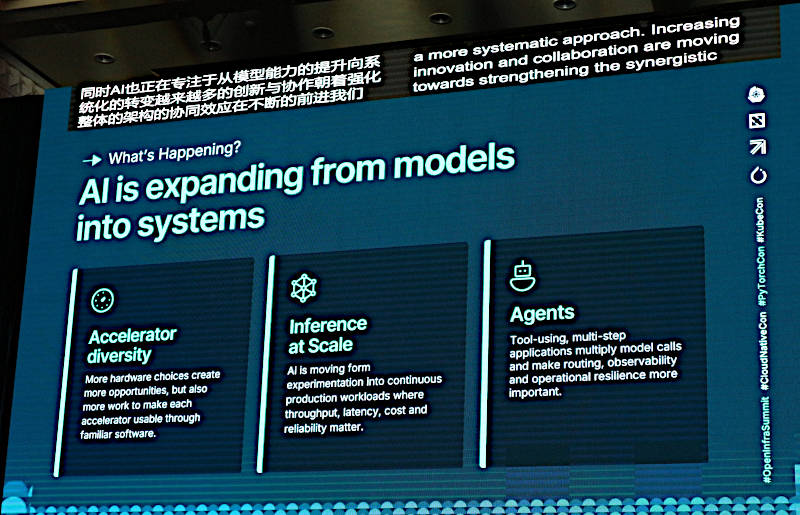
AIがモデルそのものから総合的なシステムとして解説されるように変化してきた
ここでは生成AIに代表される先進的なAIシステムがモデル単体の性能やコストというトピックから、総合的なシステムとして捉えられるようになってきたという変化を示した。これはGPUなどのアクセラレーターが多様化したこと、推論自体が大規模にスケールすることを要求されるようになったこと、機能を実装する主体がエージェントになってきたことなどを変化の要因として挙げている。
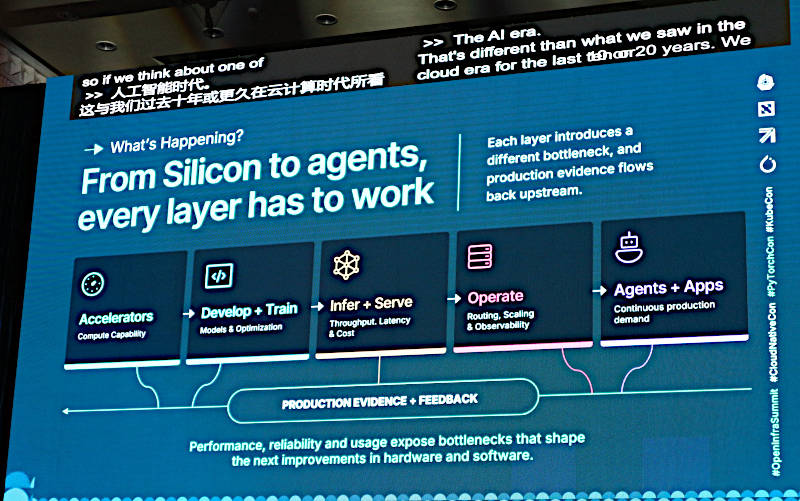
生成AIのコンポーネントを分解して解説
このスライドではアクセラレーターからエージェントによるアプリケーションに至るまでの流れを示している。GPUとは言わずに「アクセラレーター」と称していることは、中国に多く存在するアクセラレーターメーカーを意識していると思われる。モデルが学習され推論に使われる中で、モデルとアプリケーションを構成するエージェントが重要になることを強調している。特に複数のノードで実行される際のルーティングやオブザーバビリティなどもシステム全体としては意識して構成するべきだという論点だろう。
一つのソフトウェアだけでシステムは完成しない。信頼できるコンポーネントが必要
ここでモデルだけではエンタープライズが求めるAIシステムは完成しないことを強調しているのは、次のスライドの枕詞だろう。
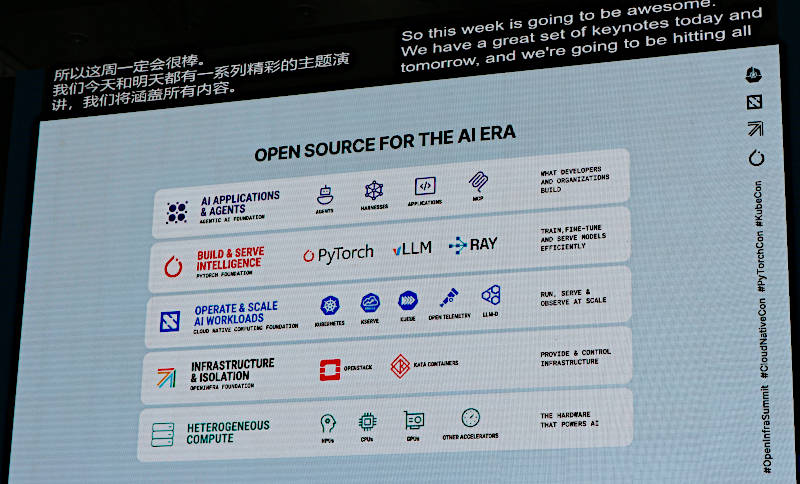
Open Source for the AI Eraのためには複数のコンポーネントが協調する必要がある
このスライドではOpenInfra Foundationのプロジェクト、PyTorch Foundationのプロジェクト、そしてCNCFのプロジェクトが協調して実行されること示している。つまりオープンソースで生成AIのシステムを実装するならこの3つの団体のソフトウェアが必要だ、だから3つの団体が協力してこのカンファレンスを開催したという整理になるわけだ。図版の中間の3層にOpenInfra Foundation、CNCF、PyTorch Foundationのプロジェクトが並んでいる。つまり、アプリケーションとハードウェア以外はこの3つの団体のソフトウェアで完成すると言いたいのであろう。
そしてここからは中国のAI関連のベンダー、AIを実際に使っている中国のエンドユーザー、中国のハードウェアメーカーが次から次へと登壇して、中国の企業が貢献しているオープンソースやアクセラレーターによってAIのエコシステムが可能になっていることを印象付ける内容となった。
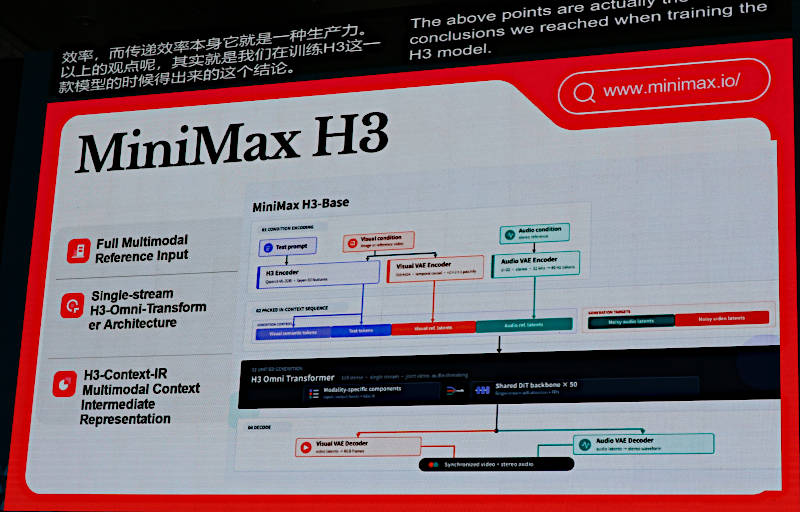
最初に登壇したRyan Lee氏はMinMaxのDevRelのトップだ
Lee氏はMinMax H3を紹介。マルチモーダルな大規模言語モデルとして単にテキストを生成するだけではなく、画像や音声も生成できることを強調。
マルチモーダルこそが誰もが使えるインテリジェンスであると訴求
次にCNCFのCTO、Chris Aniszczyk氏が登壇。Aniszczyk氏はスケーラビリティに焦点を当てて、エージェントによってこれまで以上に大量のトークンが利用されるように変化してきたこと、大規模な推論システムをスケーラブルにすることがポイントであると解説した。
CNCFのCTO、Chris Aniszczyk氏が登壇
AIシステムにおいてモデルを学習させることは大規模なGPUノードを持つモデルベンダーのタスクであるが、それを推論に使うエンドユーザーが増えたことによって全体として学習よりも推論にワークロードの量がシフトしていることを紹介。
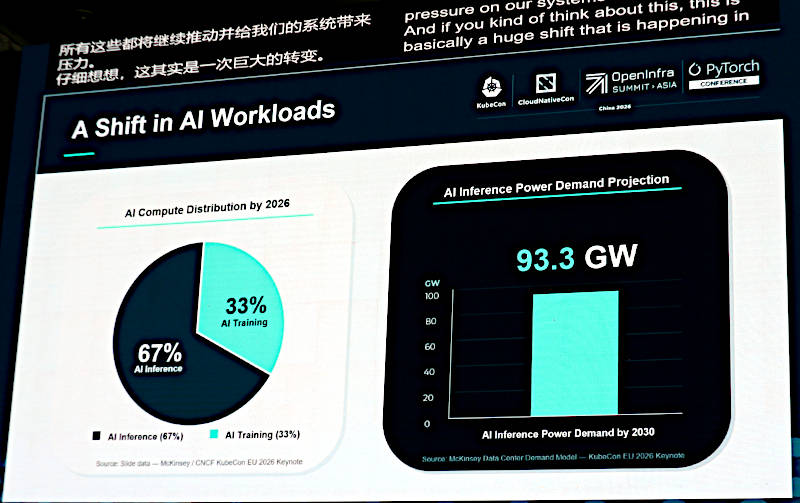
ワークロードは学習から推論にシフト。学習は33%、推論は67%
この数値は2026年3月にアムステルダムで行われたKubeCon Europeで引用されたマッキンゼーのデータであるという。モデルベンダーがどのくらいの演算時間を使っているのかは推測だろうが、実際に企業がAIをビジネスに利用している事例が今回のカンファレンスで多数紹介されていることからもAIが実用の段階に入ってきていることを示したかったのだと思われる。
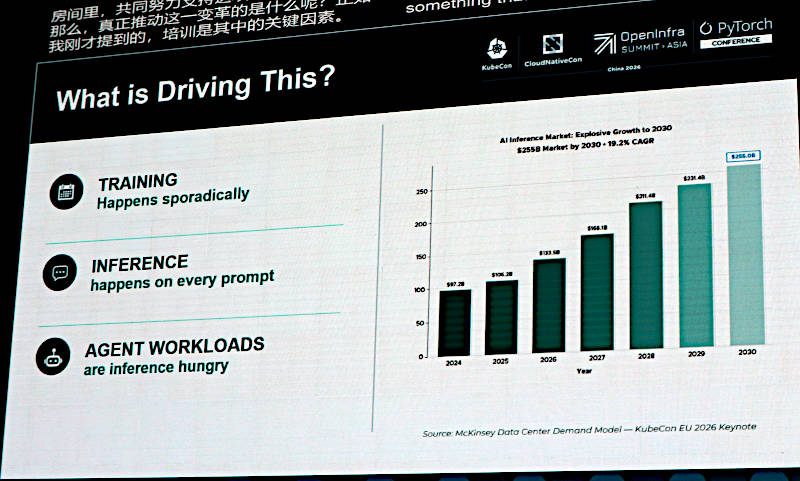
推論ワークロードが増えている要因を解説
このスライドでは学習に比べて推論のワークロードが増えているのは、学習はモデルの開発時にしか起こらないが推論はユーザーが実行するたびに開始されるからだと説明。それに加えてエージェントによって実行される推論の回数とトークン数が激増していることも指摘している。
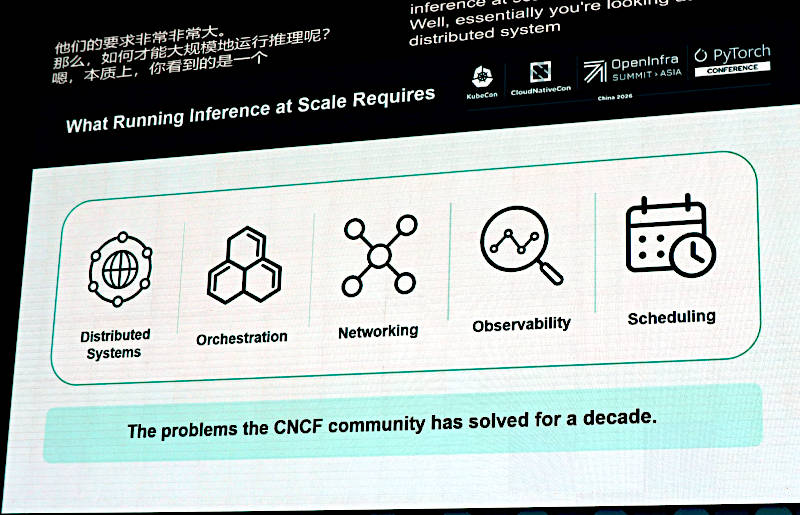
推論をスケールさせるために必要な特性を分解
このスライドでは推論のワークロードをスケールさせるために必要な特性を解説している。分散システム、オーケストレーション、ネットワーク、オブザーバビリティ、そしてスケジューリングが挙げられている。
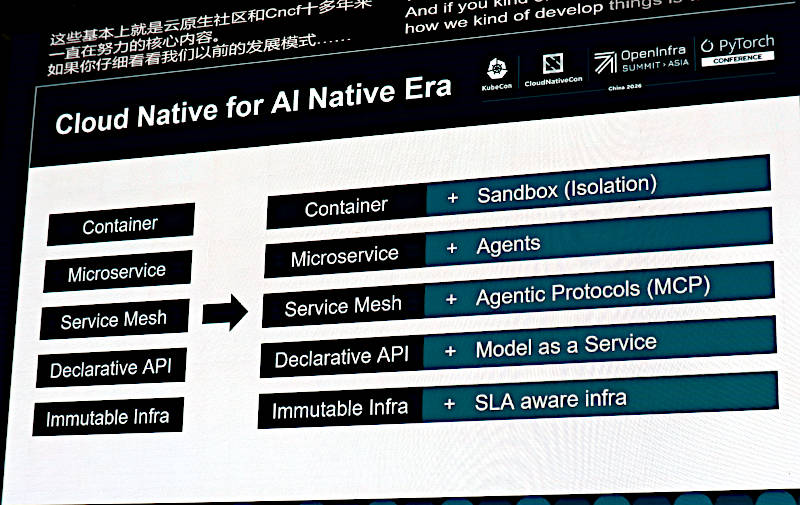
推論をスケールさせる特性はクラウドネイティブなシステムと同じ
その上でクラウドネイティブなシステムの要素に何を足せば生成AIのワークロードに適応できるのか? について、ここで整理している。コンテナにはセキュリティを守るための分離(アイソレーションやサンドボックス)が必要、マイクロサービスにはエージェントを当てはめ、サービスメッシュにはプロトコルとしてMCPを追加し、宣言的なAPIにはモデルをサービス化する仕組み、イミュータブルなインフラにはサービスレベルを観測できるインフラに変容する必要があると解説した。やや強引にクラウドネイティブなシステムの特性を生成AIに向けて化粧直しをした感が強いが、それでも生成AIのインフラとしてKubernetesが多く使われているということを再確認するための下準備という感じの説明となった。
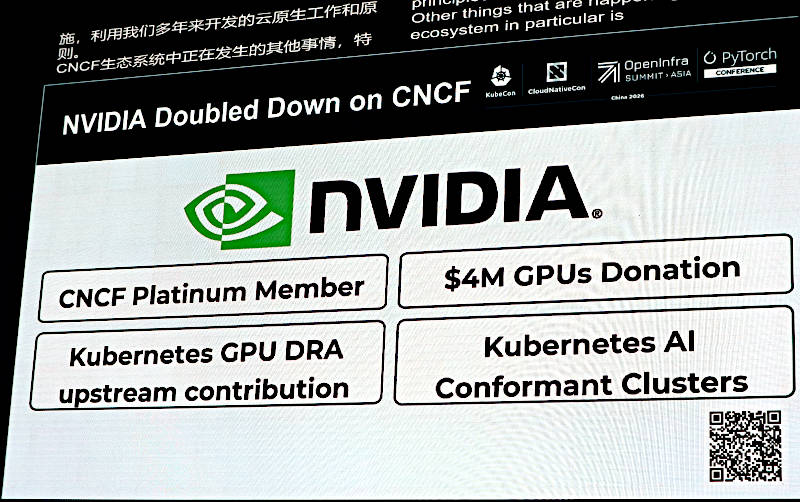
NVIDIAがプラチナムメンバーとして加入したことをここでも訴求
CNCFとしては、アクセラレーターの業界標準であるNVIDIAが参加したことを再度、強調したいのであろう。KubernetesでGPUの共有を行うDRA(Dynamic Resource Allocation)にNDIVIAが貢献していることもここでは解説されている。NVIDIAは400万ドル相当のGPUをCNCFに寄贈していることも示されている。
他にもCVS HealthやBroadcomなどもプラチナムメンバーとして加入している。ベトナムのシステムインテグレーター、Viettelもゴールドメンバーとして加入しており、自社がVMwareからOpenStackとKubernetesのオープンソースインフラに移行したセッションでは参加者からセッション後に質問攻めに遭うという状況で注目度が高かったのが意外であった。
この後はHAMiの開発元でコントリビュータであるDynamia.aiのCEO、今年のケーススタディーアワードを受賞したChina Merchants Bank(招南銀行)のエンジニアなどが登壇してプレゼンテーションを行った。
Dynamia.aiの創業者兼CEO、Xiao Zhang氏
Qwen DeepSeek V4を使った学習と推論のインフラを合体させた招南銀行のエンジニア
China Merchants BankはモデルとしてQwen DeepSeek V4を始めとして複数のモデルを使って実装されたインフラストラクチャーを解説。RayやHAMi、Fluidなどを使ってシステムを構築していると説明した。
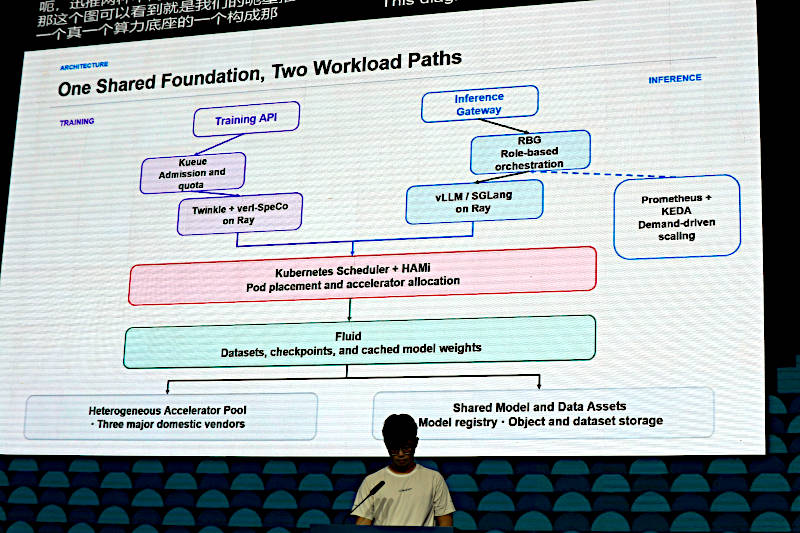
China Merchants Bankのシステム構成。学習と推論を同じインフラストラクチャーで実行
この後にPyTorch FoundationのエグゼクティブディレクターであるMark Collier氏が登壇し、PyTorchのエコシステムなどを紹介した。
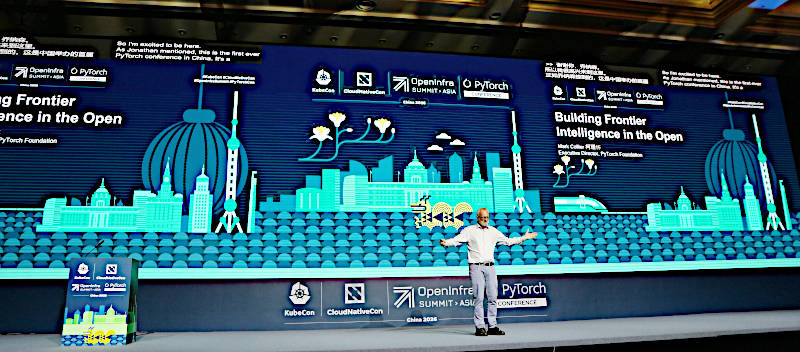
登壇したCollier氏。オープンソースでフロンティアモデルの実装を解説
MinMaxのオープンソースモデルを紹介し、オープンソースによるフロンティアモデルの開発のサイクルが進化したことなどを説明。
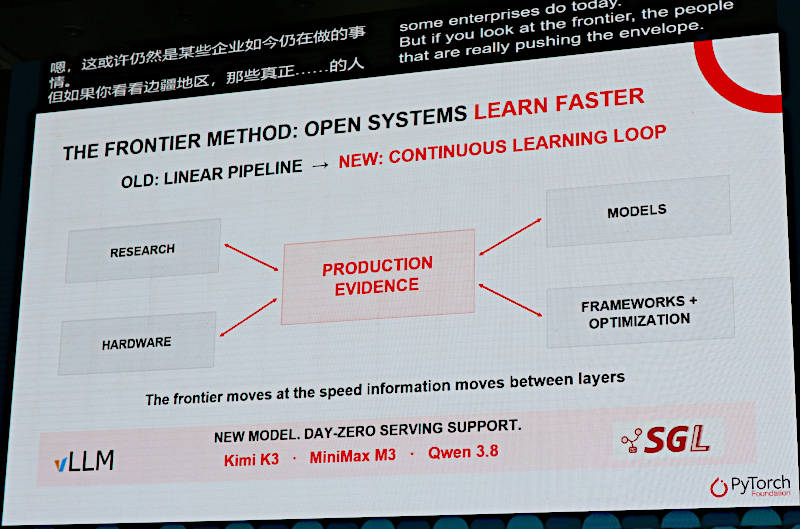
Kimi K3やMinMax M3、Qwen 3.8などを例に挙げてモデル開発のループを紹介
ここでは中国のオープンウェイトモデル、Kimi、MinMax、Qwenなどとともに、vLLM、SGLangもアイコンを付けて説明のスライドに掲載されている。ちなみにvLLMはPyTorch Foundationのホステッドプロジェクト、SGLangはPyTorch Foundationのエコシステムプロジェクトであるという。ホストされているわけではなく、PyTorchのエコシステムの中で関連が深いということだろう。
SGLangをホストしているのはLMSYSというオープンソース組織だ。SGLangの商用サービスを展開するためにRadixArkというスタートアップが作られているという。RadixArkは2日目のキーノートでSGLangとMilesというオープンソースソフトウェアを紹介するプレゼンテーションを行っている。
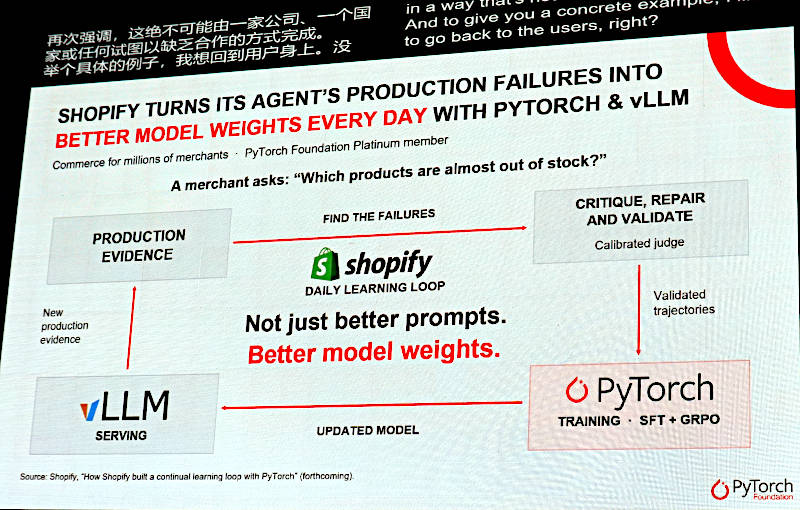
Shopifyのモデルを改善するループを解説
Collier氏はモデルを継続的に改善する手法についてShopifyのユースケースを紹介。ここでは出店者側が在庫が切れそうな商品をプロンプトとして質問し、その回答を検証し、間違っていた場合にはプロンプトを直すのではなくモデルのウェイトを直すための学習をやり直すというループを回して改善を行っているという。図版の右下のPyTorchの部分に書かれているSFTは「教師ありファインチューニング」、GRPOは「グループ相対ポリシー最適化」であり、後者は強化学習を使ってモデルの挙動を最適化する手法として紹介されている。
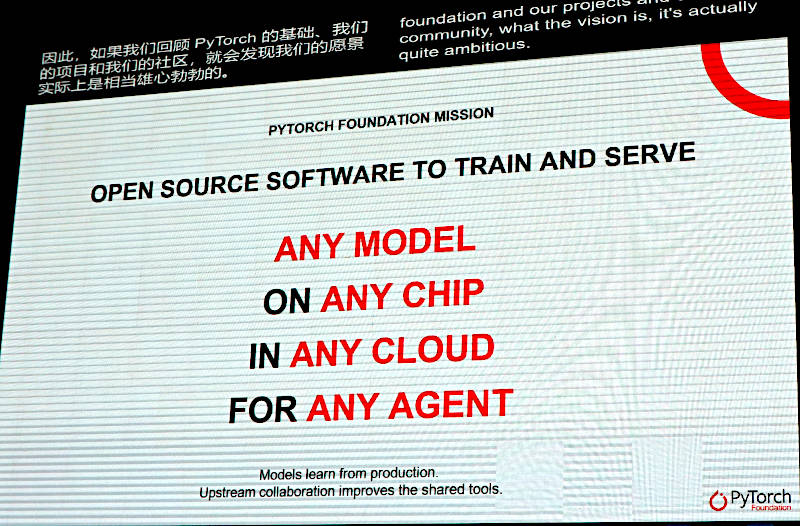
PyTorch Foundationの目的を説明
ここでPyTorch Foundationの目的を説明。「オープンソースソフトウェアによって、どのモデルでもどのチップでもどのクラウドでもどのエージェントでも学習と推論に使えること」を実現するのが目的だと訴求した。つまり単一のベンダーが占有するのではなく限りなく選択肢を増やし、ニーズに合わせて取り換えが効くようにしようという意味だろう。
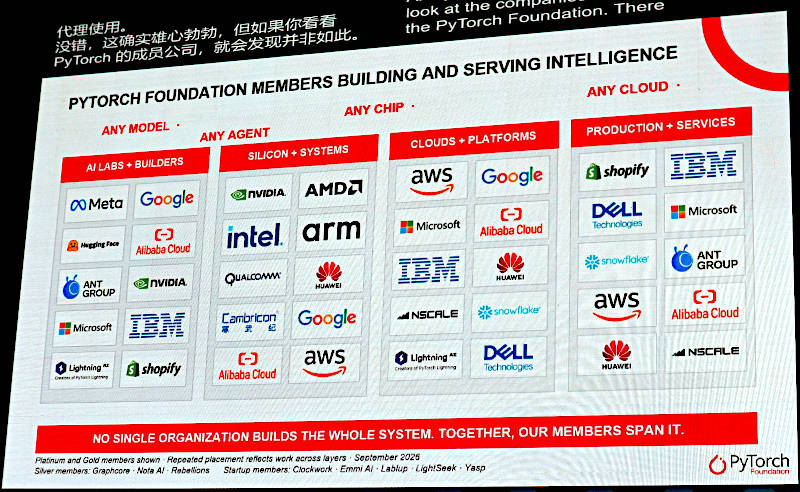
PyTorch Foundationのメンバーをモデル、チップ、クラウドに分類して表示
この図表ではモデルを開発するGoogleなどのベンダーと演算を担当するチップメーカー、クラウドプラットフォーマー、最後は利用するエンドユーザーに分類して解説している。中国での開催を意識してAlibabaやANT Group、Cambricon、Huawei/Ascendなどの中国の企業が露出している。China Merchants BankはShopifyと同じレベルでここに表示されてしかるべきだろう。同時にAlibaba Cloud、ANT GroupそしてCambriconがPyTorch Foundationのメンバーに加入したことも紹介された。
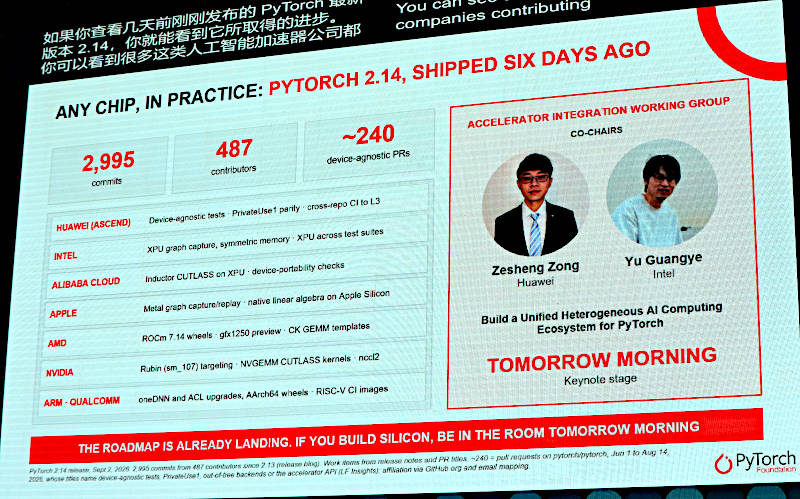
PyTorch 2.14のリリースとIntelとHuaweiによるセッションを紹介
チップメーカーが多数存在する中国において、Cambricon以外のアクセラレーターメーカーに対しても積極的に勧誘を行った。PyTorchで異機種のアクセラレーターを使うシステムに関するセッションが、HuaweiとIntelによって2日目のキーノートで紹介されることを告知。PyTorchは、NVIDIA、Intel、Arm、AMDなどのアメリカのベンダーでなくても歓迎しているということを強く訴えた形になった。
この後はHuawei、Cambricon、ANTGroupのシニアメンバーが登壇し、それぞれ自社のソリューションやオープンソースへの取り組みなどを解説。HAMiの開発元であるDynamia.aiがvLLM/llm-dのデモをリアルタイムで行うというセッションもあったが、デモが上手くいかずに動画に切り替えるという顛末もあった。
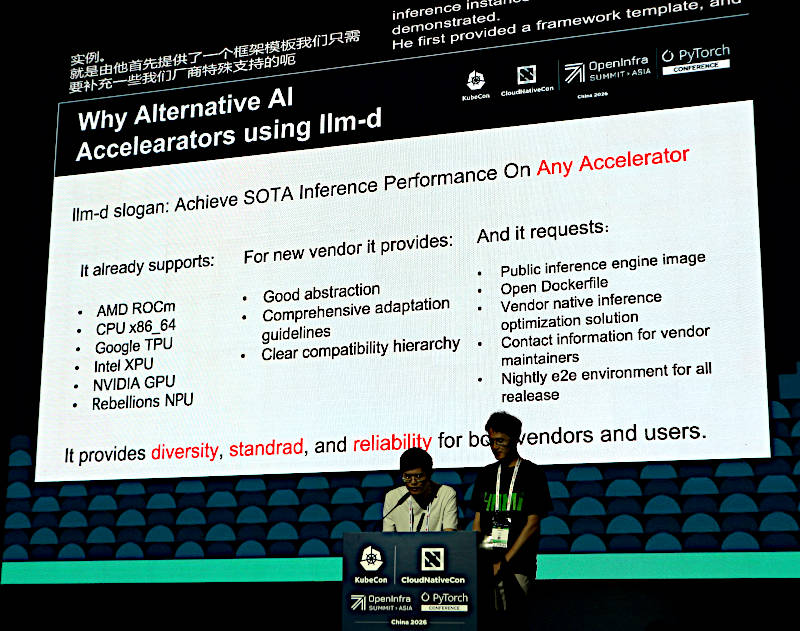
llm-dで複数のアクセラレーターがサポートされていることを示すDynamia.aiのスライド
ANT GroupのXu Wang氏は2026年7月のKubeCon Japanでデモを行ったXolisというオープンソースによるエージェントを、EKSのサンドボックス内部で実行するシステムの紹介を行った。このスタックはAWSのEKSの上にさまざまなソフトウェアを載せて、安全にエージェントを稼働させることを目指しているようだ。ANT GroupはAlibabaのグループ企業としてAlipayを開発運用している企業だと理解すると、彼らのシステムに参加者が注目するのは当然だろう。ランタイムにKata Containersを、イメージの転送にDragonflyを使い、外部のモデルの呼び出しにはZenMuxというゲートウェイを使っていることが詳細に書き込まれたスライドから読み取れる。このXolisについてはWang氏がブログの形で公開しているので、それも参考にしてほしい。
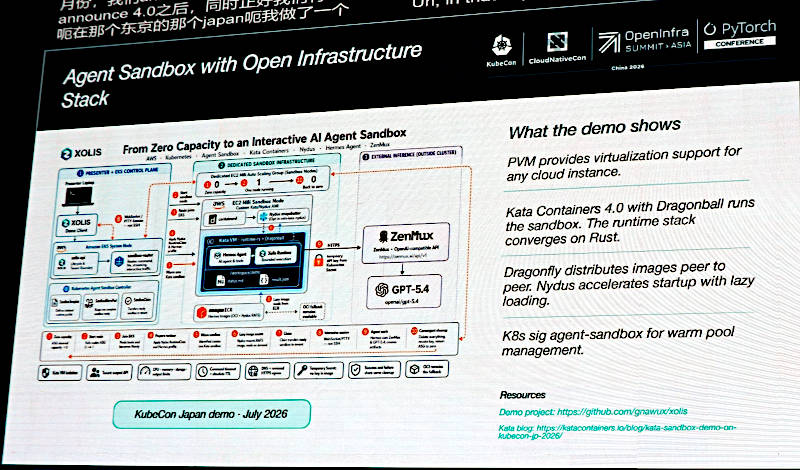
ANT GroupがAWSと外部のモデルを使ったサンドボックス実行環境を解説
●Xolisについて:Personal Project: Xolis ? A Sandbox Service Built on Kata and PVM
ちなみにこのカンファレンスのスポンサーの最上位クラスはStrategicと命名されたHuawei、その下のPlatinumがIntelとCambriconであることを考えると、前半ではNVIDIAがCNCFに対して大きな貢献を行っていることを訴求し、後半ではPyTorch Foundationの立場からHuawei、Cambriconを大きく露出させていたことが印象に残る構成だったと言える。NVIDIAはこのカンファレンスのスポンサーとしては名前が挙がっていないが、400万ドル分のGPUをCNCFに寄贈したことを考えれば、大きく露出させるのは当然だろう。
久しぶりに行われた中国本土でのKubeConは、OpenInfra Summitと併催になったことよりもPyTorch Conferenceと併催になったことで機械学習に特化した深い内容が盛り込まれ、ハードウェアも含めてオープンソースによる生成AIの現在地を知るには最適な内容となった。
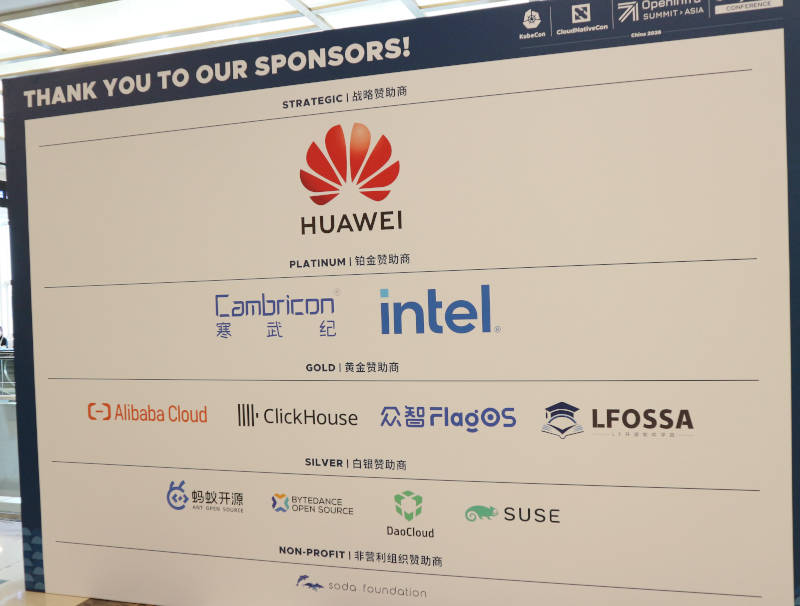
今回のスポンサーのリスト。Huaweiは最上級のスポンサーとして存在感を示していた
- この記事のキーワード
この記事をシェアしてください
バックナンバー

この記事の筆者

筆者の人気記事

マニュライフ生命のAIの責任者にインタビュー。全社員がAIを使いこなすAI for Allとは?
10月2日 6:00

【OSS Summit North America 2026】Netflixのエンジニアが開発したコンテキストを圧縮するオープンソース、Headroomを紹介
10月9日 6:00

【KubeCon Japan】KubeCon Japan 2026開催。オープンなAIを推奨する初日のキーノートを紹介
10月23日 5:59

【OSS Summit North America 2026】ドローンのグラウンドコントロールシステムであるQGC(QGroundControl)に関するセッションを紹介
11月4日 6:00

LF Energyがミートアップを実施。ヨーロッパとの違いが際立ったプレゼンテーションを紹介
10月6日 6:00

【KubeCon Japan】CNCFのリサーチ「クラウドネイティブ開発の現状」から見える日本のITが抱える問題点を考察する
10月7日 6:00
Think ITでは、技術情報が詰まったメールマガジン「Think IT Weekly」の配信サービスを提供しています。メルマガ会員登録を済ませれば、メルマガだけでなく、さまざまな限定特典を入手できるようになります。

